Automatyzacja miała skrócić obsługę, ale zespół nadal sprawdza dane, poprawia rekordy i pilnuje, czy proces doszedł do końca. Przyczyną może być błąd techniczny, zmiana reguł biznesowych albo scenariusz, którego nikt nie potrafi już bezpiecznie utrzymać.
Krótka odpowiedź
Gdy automatyzacja w Make utrudnia pracę, otwórz historię błędnego wykonania i znajdź pierwszy moduł, którego dane wejściowe lub wynik odbiegają od oczekiwań. Porównaj go z poprawnym przebiegiem, zapisz dowody i sprawdź rekord w systemie docelowym.
Napraw potwierdzoną przyczynę, uprość trudne do utrzymania wyjątki albo czasowo wyłącz scenariusz, jeśli nie da się bezpiecznie przewidzieć jego skutków.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Automatyzacje w Make, które utrudniają pracę: jak znaleźć przyczynę i je naprawić”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Po czym poznać, że automatyzacja utrudnia pracę?
Automatyzacja utrudnia pracę, gdy wymaga więcej kontroli, korekt i ponownych operacji, niż oszczędza czasu zespołu. Objawami są ręczne sprawdzanie rekordów, poprawianie pól po wykonaniu scenariusza, powracające błędy, duplikaty, brak osoby odpowiedzialnej albo niejasność, czy proces dobiegł końca. Zielony status wykonania nie dowodzi, że system docelowy otrzymał poprawne dane.
Przez ustalony okres zapisuj rodzaj sprawy, etap, czas obsługi i skutek błędu. Porównuj sprawy o podobnym przebiegu i wolumenie, aby nie pomylić problemu automatyzacji ze zmianą liczby zleceń. Rejestr powinien wskazywać osobę, która wykryła problem, oraz sposób jego rozwiązania.
Zebrane dowody pomogą ustalić, czy problem wynika z danych, konfiguracji czy organizacji pracy.
| Objaw | Możliwa przyczyna | Dowód do zebrania |
|---|---|---|
| Błąd powraca w tym samym module | Dane, uprawnienia lub mapowanie | Komunikat i nazwa modułu |
| Pracownik poprawia rekord po wykonaniu | Brak walidacji lub błędna reguła | Zmienione pole i czas korekty |
| Ponowienie tworzy drugi rekord | Brak kontroli istnienia sprawy | Identyfikatory rekordów i historia operacji |
| Alert nie prowadzi do działania | Brak właściciela lub ścieżki eskalacji | Rola odpowiedzialna i kanał alertu |
| Obsługa trwa dłużej niż przed wdrożeniem | Korekty pochłaniają oszczędność | Czas obsługi porównywalnych spraw |
Diagnozę oprzyj na powtarzalnych dowodach z procesu, a nie na samym statusie scenariusza.
Czytasz poradnik „Automatyzacje w Make, które utrudniają pracę: jak znaleźć przyczynę i je naprawić”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Dlaczego automatyzacje zawodzą po uruchomieniu?
Automatyzacje często zawodzą na granicy dwóch usług, gdy zmienia się odpowiedź API, wygasa autoryzacja lub pole przychodzi puste. API to interfejs, przez który usługi wymieniają dane. Problemy powodują też limity wywołań, timeouty, brak obsługi błędu oraz kolejne wyjątki dodawane bez przeglądu wcześniejszych reguł.
Zestaw objaw z metodą potwierdzenia i ryzykiem dla procesu. Sprawdź dane wejściowe i wyjściowe pierwszego modułu, który nie wykonał oczekiwanego działania.
| Przyczyna | Typowy objaw | Jak potwierdzić | Ryzyko |
|---|---|---|---|
| Zmiana API lub aplikacji | Brak pola albo inna struktura odpowiedzi | Porównaj wynik modułu z wcześniejszym poprawnym przebiegiem | Błędne mapowanie zapisze nieprawidłową wartość |
| Niepełne dane wejściowe | Błąd walidacji lub zatrzymany przebieg | Sprawdź pakiet wejściowy i warunki filtra | Niekompletny rekord przejdzie dalej |
| Limit lub przeciążenie | HTTP 429, timeout albo błąd połączenia | Porównaj komunikat usługi i czas zdarzenia | Nadmiar prób może zwiększyć opóźnienie |
| Brak obsługi błędu | Przebieg zatrzymuje się bez reakcji zespołu | Odtwórz problem w bezpiecznych warunkach i sprawdź alert | Sprawa może pozostać bez właściciela |
| Nadmiar wyjątków | Wiele podobnych filtrów i rozgałęzień | Powiąż każdą gałąź z zatwierdzoną regułą | Zmiana jednej reguły może zaburzyć inne |
Przyczynę potwierdza komunikat, dane modułu i wynik w usłudze docelowej, a nie sam fakt zgłoszenia błędu przez scenariusz.
Jak zmierzyć koszt źle zaprojektowanego procesu?
Miesięczny koszt poprawek obejmuje korekty ręczne, nadzór, ponowne wykonania i udokumentowane skutki błędów. Porównuj okresy o podobnej liczbie spraw, a czas pracy przeliczaj według stawki przyjętej w firmie.
Zmierz czas obsługi typowej sprawy przed wdrożeniem. Po wdrożeniu osobno zapisuj czas kontroli człowieka, korekt i ponownych operacji. Do kosztu dodawaj tylko potwierdzone skutki, na przykład koszt ponownej wysyłki lub obsługi reklamacji.
Poniższe składniki można wprowadzić do prostego arkusza pomiarowego. Każdy licz dla tego samego okresu rozliczeniowego.
| Składnik miesięczny | Obliczenie |
|---|---|
| Korekty ręczne | Liczba korekt x średni czas korekty x koszt godziny pracy |
| Nadzór | Godziny kontroli i przeglądu logów x koszt godziny pracy |
| Ponowne wykonania | Czas odtworzenia spraw x koszt godziny pracy |
| Skutki błędów | Suma udokumentowanych kosztów reklamacji i opóźnień |
Miesięczny koszt poprawek = korekty ręczne + nadzór + ponowne wykonania + udokumentowane skutki błędów. Porównaj wynik z oszczędzonym czasem i kosztem utrzymania. Jeśli źródłem kosztu jest wadliwy przepływ, analiza i wdrożenie automatyzacji procesów może objąć przegląd reguł, integracji i testów poprawki.
Jak znaleźć miejsce, w którym scenariusz się psuje?
Pierwszy niezgodny moduł wskazuje, gdzie dane lub działanie zaczynają odbiegać od oczekiwanego wyniku. W Make otwórz scenariusz, przejdź do History i wybierz konkretne wykonanie. W n8n wybierz Overview, następnie Executions, odfiltruj wykonania ze statusem Failed i otwórz przebieg, aby prześledzić węzły oraz ich dane.
Porównaj dane wejściowe i wyjściowe pierwszego wadliwego modułu z podobnym, poprawnym wykonaniem. Sprawdź identyfikatory, typy i puste wartości, warunki filtrów, odpowiedź API, uprawnienia połączenia oraz limity wywołań. Zapisz ID wykonania, wersję scenariusza, czas, nazwę modułu, komunikat, kod odpowiedzi i zanonimizowany przykład danych.
Przykładowy komunikat CRM to "BundleValidationError: Missing value of required parameter 'email'". Najpierw sprawdź wyjście modułu pobierającego dane kontaktu, a potem mapowanie pola e-mail w pierwszym module CRM, który go wymaga. Jeśli źródło nie zwraca adresu, błąd zaczyna się przed CRM; jeśli wartość jest obecna, sprawdź mapowanie i wymagania pola docelowego.
Przed ponowieniem sprawdź, czy działanie nie powiodło się już częściowo. Jako klucz kontaktu stosuj identyfikator rekordu CRM albo niezmienny identyfikator osoby ze źródła. E-mail może być kluczem tylko wtedy, gdy system gwarantuje jego unikalność, a reguła procesu uznaje go za właściwy identyfikator; ID zamówienia identyfikuje zamówienie, nie kontakt.
Perspektywa KC Mobile: błąd techniczny i nieaktualna reguła biznesowa mogą wyglądać podobnie w historii wykonania. Przed zmianą warunku uzgadniamy z właścicielem procesu oczekiwany wynik dla konkretnego wyjątku, zamiast zmieniać logikę na podstawie jednego nietypowego rekordu.
W Make otwórz Scenario settings ikoną koła zębatego w edytorze scenariusza. Ustawienie Store incomplete executions zapisuje nieukończone wykonania i jest domyślnie wyłączone. Process data in order uruchamia wykonania kolejno; gdy występuje nieukończone wykonanie, Make wstrzymuje kolejne do czasu jego rozwiązania. Limit przechowywania nieukończonych wykonań zależy od przydziału użycia organizacji. Logi mogą zawierać dane przetwarzane w przebiegu, dlatego ogranicz dostęp i anonimizuj przykłady przekazywane do analizy.
Naprawić scenariusz, uprościć go czy wyłączyć?
Napraw scenariusz, gdy przyczyna jest znana i można ją odtworzyć w teście. Uprość przepływ, jeśli podobne wyjątki tworzą wiele gałęzi, których skutków trudno dopilnować. Czasowo wyłącz automatyzację, gdy przyczyna pozostaje nieznana, a błędny wynik może zaszkodzić klientom, finansom lub realizacji zamówień.
Dobierz działanie do częstotliwości błędu, kosztu obejścia, krytyczności procesu i dostępności właściciela. Bezpieczny powrót do pracy ręcznej powinien być warunkiem wyłączenia scenariusza.
| Kryterium | Naprawić | Uprościć | Wyłączyć czasowo |
|---|---|---|---|
| Źródło błędu | Potwierdzone i ograniczone | Wynika z nadmiaru podobnych reguł | Nieznane lub skutki są poważne |
| Koszt obejścia | Poprawka jest tańsza niż dalsza obsługa | Ręczne korekty wynikają ze złożoności | Obsługa ręczna jest wykonalna i kontrolowana |
| Właściciel procesu | Dostępny do testu i odbioru | Zatwierdzi uproszczone reguły | Brak osoby uprawnionej do decyzji |
| Krytyczność procesu | Test ogranicza skutki błędu | Zakres zmian można podzielić | Błędne działanie zagraża klientom lub danym |
| Powrót do pracy ręcznej | Jest plan wycofania | Można przejąć wybrane etapy | Sprawy mają rejestr i kontrolę duplikatów |
Wyłączaj scenariusz razem z planem obsługi nowych spraw i kontroli już rozpoczętych wykonań. Wskaż osobę obsługującą nowe sprawy, miejsce rejestracji oraz sposób potwierdzania, że dana czynność nie została już wykonana. Ustal postępowanie z kolejką i zapisanymi niekompletnymi wykonaniami; do automatyzacji wróć po testach i odbiorze właściciela procesu.
Jak zaprojektować automatyzację odporną na błędy?
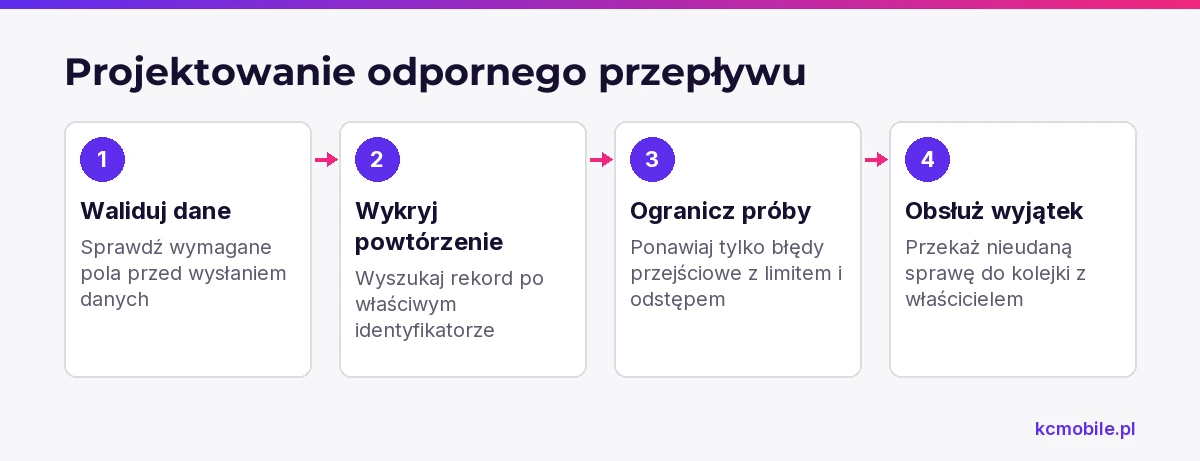
Odporna automatyzacja sprawdza dane przed zapisem, rozpoznaje ponowione zdarzenie i przekazuje wyjątki do kontrolowanej obsługi. Idempotencja oznacza, że ponowne przetworzenie tego samego zdarzenia nie tworzy kolejnego skutku, na przykład drugiego rekordu. Klucz idempotencji pomaga tylko wtedy, gdy obsługuje go API lub system docelowy.
Przed utworzeniem rekordu wyszukaj go po identyfikatorze, którego unikalność egzekwuje system docelowy. Gdy rekord istnieje, aktualizuj go lub zakończ przebieg zgodnie z regułą procesu. Waliduj wymagane pola przed wysłaniem danych, a błędy walidacji kieruj do korekty zamiast ponawiać identyczne żądanie.
Ponawiaj wyłącznie błędy przejściowe, takie jak limit lub krótkotrwały problem połączenia. Ogranicz liczbę prób i odstępy, a po nieudanej serii umieść sprawę w kolejce błędów z alertem i właścicielem decyzji. W Make Retry error handler zapisuje szczegóły błędu i pozostałą część przebiegu jako nieukończone wykonanie; do jego działania trzeba włączyć Store incomplete executions. Make obsługuje też automatyczne ponowienia wybranych błędów przejściowych.
W n8n można skonfigurować workflow obsługi błędów z węzłem Error Trigger. Przed wznowieniem sprawdź stan rekordu docelowego, aby nie powtórzyć zakończonej już operacji. Alert powinien wskazywać identyfikator sprawy, etap i osobę odpowiedzialną za decyzję.
Jak uporządkować scenariusze w Make lub n8n?
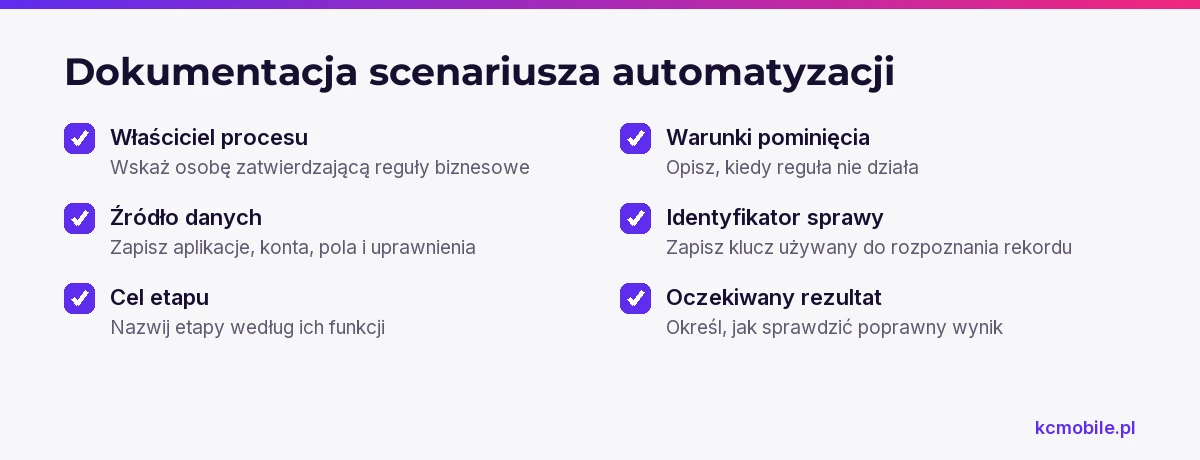
Czytelny scenariusz wskazuje właściciela, źródło danych i skutek każdej reguły bez odgadywania intencji autora. Nazywaj etapy według funkcji, na przykład "Walidacja zamówienia", i opisz warunki pominięcia, identyfikator sprawy oraz oczekiwany rezultat. Oddziel logikę biznesową od technicznej obsługi błędów, aby właściciel procesu mógł zatwierdzić reguły bez analizowania całej konfiguracji.
Zapisz zależności od aplikacji, kont, pól i uprawnień. Przypisz właściciela biznesowego do reguł procesu, a technicznego do połączeń i utrzymania scenariusza. Testuj kopię na danych przykładowych lub środowisku testowym; do testów produkcyjnych używaj wyłącznie trybu, który nie tworzy prawdziwych rekordów ani komunikatów.
Zmianę Make lub n8n uzasadnia konkretne ograniczenie obecnego rozwiązania, na przykład brak wymaganego hostingu, kontroli nad danymi lub potrzebnej integracji. Migracja bez poprawy reguł biznesowych przenosi te same błędy do nowego narzędzia.
Jeśli automatyzacja obejmuje obsługę potencjalnych klientów, zestaw ją z automatyzacją sprzedaży z AI. Szersze zastosowania opisują przykłady automatyzacji Make w firmie.
Jak wdrażać zmiany bez zatrzymania firmy?
Bezpieczna poprawka zachowuje poprzednią wersję, przechodzi test na kopii i ma określony warunek wycofania. Przed zmianą zapisz konfigurację scenariusza, połączenia, ustawienia uruchamiania i zależności. Testuj przypadki obejmujące poprawne dane, brak pola, ponowione zdarzenie i chwilową awarię API.
Wersję równoległą uruchamiaj tylko w trybie, który nie tworzy produkcyjnych rekordów, dokumentów ani komunikatów. Porównaj jej wynik z dotychczasowym przepływem i skontroluj końcowy rekord w systemie docelowym, nie tylko status modułu. Ustal warunek wycofania, na przykład duplikat, brak wymaganej informacji albo niezgodność z zatwierdzoną regułą.
Checklistę odbioru zapisuj przy każdej poprawce:
- potwierdzono przyczynę na odtwarzalnym wykonaniu;
- sprawdzono poprawny przebieg i przypadki brzegowe;
- ponowienie nie tworzy duplikatu ani podwójnego skutku;
- właściciel procesu zaakceptował wynik w systemie docelowym;
- istnieje kopia, osoba odpowiedzialna i warunek wycofania.
Po przełączeniu monitoruj przez tydzień błędy, czas korekt i liczbę spraw przejętych ręcznie. Jeśli poprawka nadal generuje wyjątki, wróć do kontrolowanej obsługi ręcznej i ponownie zdiagnozuj pierwszy niezgodny moduł. Jeśli zespół potrzebuje wsparcia w przeprojektowaniu przepływu, wdrożenie automatyzacji procesów w firmie może objąć diagnozę, poprawę i plan bezpiecznego przełączenia.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Co oznacza błąd HTTP 429 w scenariuszu Make?
Czy zielony status wykonania potwierdza poprawny wynik w CRM?
Kiedy włączyć Process data in order w Make?
Jak przekazać scenariusz Make do utrzymania innej osobie?
Ile kosztuje utrzymanie automatyzacji biznesowej?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Automatyzacje w Make, które utrudniają pracę: jak znaleźć przyczynę i je naprawić”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.