Nieskończone przewijanie skraca drogę do kolejnych produktów lub wpisów, ale może utrudnić ich znalezienie, jeśli lista działa wyłącznie jako jeden strumień w przeglądarce. W sklepie trzeba połączyć płynne przeglądanie z odtwarzalnymi adresami kolejnych porcji i linkami, które prowadzą do dalszych stron.
Krótka odpowiedź
Infinite scroll może współistnieć z SEO, jeśli każda porcja listy ma własny, trwały URL, a kolejne adresy łączą zwykłe linki HTML. Google zaleca też, by zawartość pod danym adresem pozostawała stała, a każda strona paginacji miała własny canonical.
Praktyczny wzorzec to działająca paginacja jako podstawa oraz automatyczne doładowanie jako sposób prezentacji listy.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Infinite scroll: jak działa nieskończone przewijanie i jaki ma wpływ na SEO”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czym jest infinite scroll i kiedy się go stosuje?
Infinite scroll, czyli nieskończone przewijanie, automatycznie dołącza kolejne elementy listy, gdy użytkownik zbliża się do jej końca. Stosuje się go na stronach kategorii sklepów, w archiwach blogów i serwisach z dużą liczbą wpisów. Wersja przyjazna wyszukiwarkom nadal udostępnia kolejne porcje pod osobnymi adresami.
W sklepie taki układ ogranicza przejścia między stronami kategorii, a w archiwum bloga pozwala czytać kolejne wpisy w jednym ciągu. Przy długiej liście trzeba jednak zapewnić orientację: użytkownik powinien móc wrócić do filtrów, stopki lub wybranego produktu bez utraty miejsca.
Z naszych wdrożeń wynika, że problemy ujawniają się przy połączeniu doładowania z filtrowaniem, sortowaniem i powrotem z karty produktu. Dlatego przed zmianą interfejsu sprawdzamy, czy po odświeżeniu adres odtwarza tę samą listę. W ramach pozycjonowania SEO dla sklepu i serwisu oceniamy także, czy robot może przejść do kolejnych adresów.
Czytasz poradnik „Infinite scroll: jak działa nieskończone przewijanie i jaki ma wpływ na SEO”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak infinite scroll wpływa na indeksowanie?
Google może odkrywać kolejne elementy listy, gdy każda porcja ma unikalny, trwały URL i prowadzi do niej link HTML z atrybutem href. Widoczność produktu po doładowaniu w przeglądarce nie potwierdza jeszcze, że jego adres jest dostępny w strukturze linków serwisu.
Google Search Central opisuje osobne adresy stron paginacji, sekwencyjne linkowanie do następnych stron i stałą zawartość pod każdym adresem. Google zaznacza, że roboty odkrywają adresy z atrybutu href elementu a, a interakcje użytkownika nie powinny być jedyną drogą do kolejnych wyników. Szczegóły opisuje dokumentacja paginacji i ładowania przyrostowego Google.
Strona kategorii i karta produktu to osobne zasoby: kategoria powinna zawierać linki do produktów, a URL porcji powinien odtwarzać właściwy zestaw elementów. Sitemap lub feed Google Merchant Center mogą pomóc w odkrywaniu produktów, ale nie zastępują linkowania wewnętrznego. Więcej o dostępie robota do stron opisujemy w materiale o crawlowaniu i pozycjach w Google.
Infinite scroll czy paginacja: co wybrać?
Paginacja najlepiej sprawdza się wtedy, gdy użytkownik ma znać pozycję i rozmiar listy, a infinite scroll pasuje do płynnego przeglądania krótszych zbiorów. Przycisk "Załaduj więcej" daje użytkownikowi kontrolę nad momentem dołączenia kolejnych elementów. Każdy z tych wzorców można oprzeć na dostępnych adresach kolejnych porcji.
| Wzorzec listy | SEO i odkrywanie URL-i | Orientacja użytkownika | Dostępność i utrzymanie |
|---|---|---|---|
| Paginacja | Linki prowadzą do osobnych stron | Widoczna pozycja na liście | Proste sterowanie klawiaturą |
| Przycisk "Załaduj więcej" | Wymaga dodatkowych linków do stron | Użytkownik decyduje o doładowaniu | Wymaga komunikatu stanu i obsługi błędu |
| Infinite scroll | Wymaga adresów i linków do porcji | Płynne przeglądanie, słabsza orientacja | Wymaga synchronizacji URL i stanu listy |
Wniosek: dla dużego katalogu najłatwiej utrzymać paginację jako podstawę techniczną, a przycisk lub automatyczne doładowanie dodać jako warstwę interfejsu.
Google porównuje te wzorce w oficjalnym przewodniku wyboru strategii UX. Z perspektywy SEO istotna jest możliwość dotarcia do stron listy, a wybór interakcji powinien dodatkowo uwzględniać rozmiar katalogu i wygodę na telefonie.
Jak wdrożyć nieskończone przewijanie bez blokowania SEO?
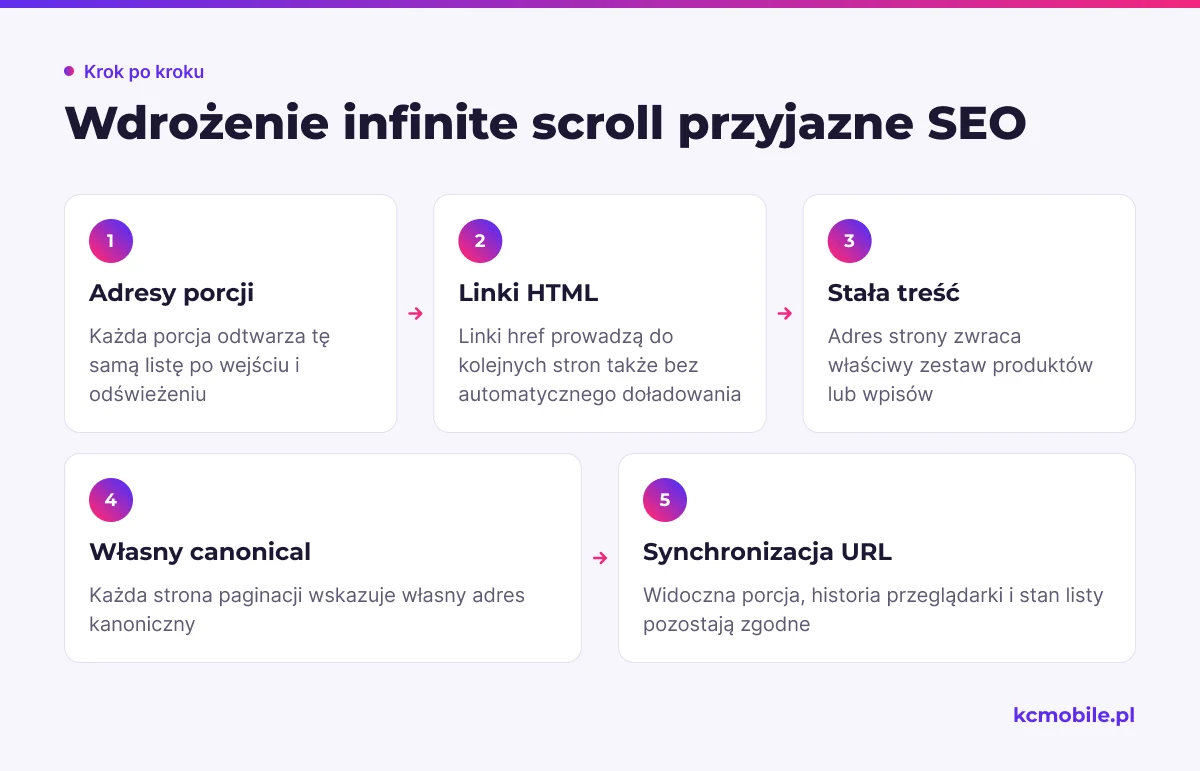
Bezpieczne wdrożenie zaczyna się od działających stron paginacji, a kończy na skrypcie, który dołącza kolejne strony do widoku. Google zaleca trwały, unikalny URL dla każdej porcji oraz stałą zawartość pod tym adresem. Pełne zalecenia zawiera dokumentacja Google o infinite scroll i paginacji.
1. Ustal adresy porcji. Użyj na przykład `/kategoria/?page=2`, tak aby bezpośrednie wejście i odświeżenie odtwarzały te same produkty.
2. Dodaj linki HTML. Umieść elementy `` prowadzące do następnej strony. Przycisk może dołączać produkty do widoku, ale nie powinien zastępować linku.
3. Udostępnij treść pod każdym adresem. Strona numerowana powinna zwracać karty produktów lub wpisów. Sprawdź treść także po wyłączeniu skryptu do automatycznego doładowania.
4. Ustaw właściwy canonical. Każda odrębna strona paginacji powinna wskazywać własny adres kanoniczny, a nie automatycznie adres pierwszej strony. Google traktuje canonical jako wskazówkę przy wyborze wersji kanonicznej.
5. Synchronizuj pasek adresu. Gdy dołączona porcja staje się główną widoczną częścią listy, aktualizuj URL przez History API. Obsłuż przyciski wstecz i dalej oraz odtworzenie listy po odświeżeniu.
6. Zachowaj przejście bez skryptu. Linki paginacji powinny nadal prowadzić do działających stron, gdy JavaScript się nie uruchomi.
Nie kieruj canonicali wszystkich porcji na pierwszą stronę kategorii, jeśli każda zawiera inny zestaw produktów. Problemy z indeksowaniem, canonicalem i renderowaniem omawia nasz przewodnik Technical SEO.
Jak sprawdzić, czy Google widzi kolejne elementy listy?
Sprawdź URL kolejnej porcji bez wcześniejszego przewijania, a następnie porównaj źródłowy HTML, wyrenderowany DOM i wynik inspekcji adresu w Google Search Console. Źródłowy HTML może nie zawierać linków dodanych przez JavaScript, dlatego jego samodzielna kontrola nie wystarcza.
- Otwórz URL drugiej porcji bezpośrednio w nowej karcie i sprawdź, czy pojawia się właściwy zestaw produktów.
- W źródłowym HTML wyszukaj elementy `` prowadzące do kolejnych stron i kart produktów.
- W narzędziach deweloperskich sprawdź wyrenderowany DOM po załadowaniu skryptów i porównaj listę linków z HTML.
- W Google Search Console otwórz inspekcję adresu URL. Sprawdź wyrenderowaną stronę, pobrane zasoby oraz deklarowany i wybrany przez Google canonical.
- Sprawdź odpowiedź serwera, kolejność produktów po odświeżeniu i działanie adresu w oknie prywatnym.
Google wyjaśnia, że inspekcja URL pozwala sprawdzić wyrenderowany DOM, zasoby i błędy JavaScript. Opis narzędzia znajduje się w pomocy Google Search Console, a instrukcja testowania renderowania w dokumentacji Google dla problemów z JavaScript. Jeśli adres działa wyłącznie jako stan przeglądarki, nie odtwarza samodzielnie konkretnej porcji.
Jak zachować użyteczność i dostępność?
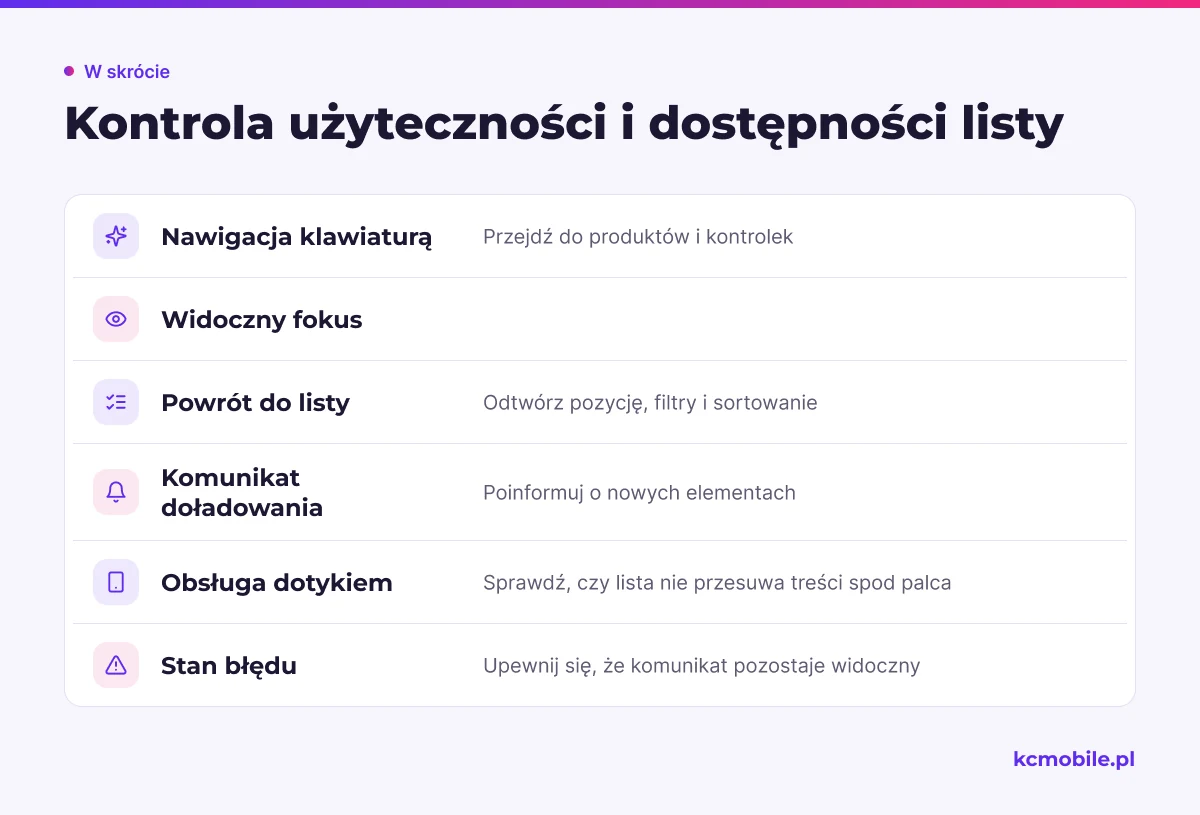
Lista z infinite scroll powinna pozwalać przejść klawiaturą do produktów i kolejnych kontrolek, zachować widoczny fokus oraz przywrócić pozycję po powrocie z karty produktu. W3C opisuje wymaganie, by przewijalna treść była osiągalna przez nawigację fokusem, jeśli klawiatura ma służyć do przewijania. Szczegóły zawiera reguła WAI dotycząca przewijalnej treści.
Przycisk "Załaduj więcej" daje użytkownikowi kontrolę, a paginacja zapewnia alternatywną drogę do kolejnych wyników. Po doładowaniu poinformuj technologie asystujące o liczbie nowych elementów przez region statusu, nie przenoś fokusu bez potrzeby i zachowaj logiczną kolejność klawiatury.
Przy powrocie z karty produktu przywróć pozycję, filtry i sortowanie, jeśli użytkownik wraca do tej samej listy. Na telefonie sprawdź, czy doładowanie nie przesuwa treści spod palca ani nie zasłania komunikatu o błędzie. Test obejmuje klawiaturę, czytnik ekranu i obsługę dotykiem.
Jak mierzyć działanie listy po wdrożeniu?
Mierz osobno doładowanie, kliknięcia produktów, zmianę adresu porcji, błędy i zakupy, a wyniki dziel według urządzenia. Sama liczba odsłon nie pokazuje, czy dołączone produkty zainteresowały użytkownika.
| Zdarzenie | Zapisane dane | Wskaźnik | Podział urządzenia |
|---|---|---|---|
| Doładowanie porcji | Numer strony i wynik żądania | Udział udanych doładowań | Telefon, komputer, tablet |
| Kliknięcie produktu | Identyfikator i pozycja produktu | Kliknięcia na porcję | Telefon, komputer, tablet |
| Zmiana URL | Adres widocznej porcji | Przejścia między stronami listy | Telefon, komputer, tablet |
| Błąd ładowania | Kod błędu i numer porcji | Błędy względem żądań | Telefon, komputer, tablet |
| Zakup | Transakcja i lista źródłowa | Konwersje z kategorii | Telefon, komputer, tablet |
Wniosek: rozdzielenie kliknięcia produktu od doładowania ujawnia, czy interakcja wspiera wybór, czy tylko dodaje kolejne elementy do listy.
W GA4 zdarzenia można wysyłać przez Google Tag Manager albo kod pomiarowy, stosując spójne parametry, takie jak numer strony listy i identyfikator produktu. Nie dodawaj danych osobowych do parametrów zdarzeń. Przed porównaniem wyników sprawdź, czy te same zdarzenia działają na telefonie i komputerze.
Jakie błędy najczęściej psują widoczność?
Widoczność listy najczęściej ogranicza brak adresów kolejnych porcji, powielona zawartość albo konfiguracja, która zwraca tę samą stronę dla każdego URL-a. Każdy z tych błędów utrudnia odtworzenie listy i powiązanie produktu z kategorią.
- Treść dostępna tylko po interakcji: nie ma równoważnej strony z kolejną porcją.
- Brak linków do porcji: skrypt wykonuje żądanie, ale HTML ani wyrenderowany DOM nie udostępnia linku do dalszej strony.
- Błędny canonical: różne strony listy wskazują jako canonical pierwszy adres kategorii.
- Powielona zawartość: adresy `?page=2` i `?page=3` zwracają ten sam zestaw produktów.
- Utrata stanu: powrót z produktu kasuje filtry i przenosi użytkownika na początek listy.
- Niespójność danych: URL porcji zwraca inny zestaw niż interfejs po doładowaniu.
- Brak paginacji: użytkownik nie ma prostego przejścia do końca katalogu.
Przed poprawką sprawdź canonical, dyrektywę `noindex` i odpowiedź serwera dla każdej porcji. Zespół, który chce połączyć wygodę listy z poprawną strukturą URL-i, może zlecić optymalizację widoczności w wyszukiwarce po audycie kategorii.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Czy Google indeksuje treści ładowane przez infinite scroll?
Czy infinite scroll poprawia pozycje w Google?
Jak połączyć przycisk "Załaduj więcej" z paginacją?
Czy można użyć fragmentu #page=2 jako adresu porcji?
Czy linki widoczne dopiero po JavaScript oznaczają, że konfiguracja jest błędna?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Infinite scroll: jak działa nieskończone przewijanie i jaki ma wpływ na SEO”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.