Podział aplikacji na moduły może ułatwić pracę zespołów, ale komplikuje ustalenie, która warstwa odpowiada za treść, adres i metadane strony. O widoczności decyduje wynik dostępny pod konkretnym URL oraz to, czy wyszukiwarka może go pobrać i zinterpretować.
Krótka odpowiedź
Microfrontends same w sobie nie obniżają widoczności w Google. Ryzyko zależy od tego, czy strona zwraca właściwy status HTTP, udostępnia główną treść i linki oraz prezentuje spójne metadane po renderowaniu.
Google przetwarza strony JavaScript w trzech etapach: crawlowania, renderowania i indeksowania. Porównaj odpowiedź HTTP, surowy HTML, DOM po wykonaniu skryptów i wynik Inspekcji adresu URL w Google Search Console.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Wpływ microfrontends na SEO: renderowanie, indeksacja i testy”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czy microfrontends same w sobie szkodzą SEO?
Microfrontends same w sobie nie szkodzą SEO, ponieważ o indeksacji decyduje odpowiedź dostępna pod konkretnym adresem URL. Moduły mogą być składane podczas budowania, na serwerze albo w przeglądarce. Każdy wariant może działać, jeśli robot otrzymuje treść, linki i właściwe sygnały dla danej trasy.
Składanie podczas budowania łączy moduły przed publikacją. Składanie po stronie serwera tworzy dokument w odpowiedzi na żądanie. Składanie po stronie klienta dostarcza początkowy dokument, a JavaScript uzupełnia widok w przeglądarce.
Ryzyko powstaje często na granicy zespołów. Powłoka aplikacji może zwrócić kod 200 dla nieistniejącej trasy, moduł może ustawić własny canonical, a router może zmienić title po pierwszym renderowaniu. Efektem może być pusta treść, sprzeczne metadane albo strona błędu potraktowana jak poprawna.
Nie wybieramy SSR tylko dlatego, że aplikacja korzysta z microfrontends. Najpierw sprawdzamy ważne adresy, odpowiedzi i wyrenderowaną treść. Przy szerszej ocenie witryny przyda się poradnik SEO WordPress: plan optymalizacji i kontrola efektów. Jeśli problem dotyczy widoczności ważnych stron, pozycjonowanie SEO może objąć audyt techniczny i plan naprawczy.
Czytasz poradnik „Wpływ microfrontends na SEO: renderowanie, indeksacja i testy”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak Googlebot przetwarza stronę opartą na JavaScript?
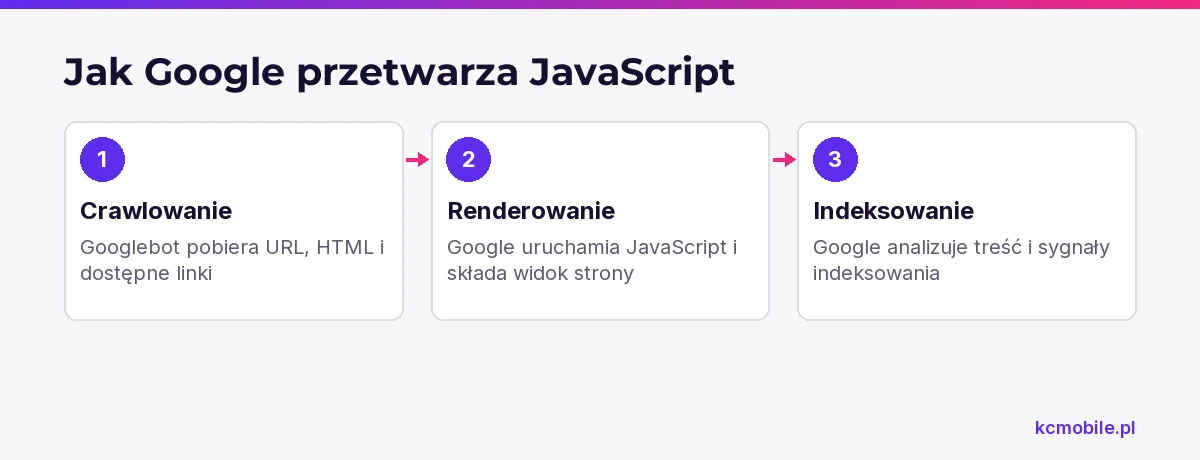
Google przetwarza aplikacje JavaScript w trzech głównych fazach: crawlowania, renderowania i indeksowania. Podczas crawlowania Googlebot pobiera URL oraz odczytuje HTML i dostępne linki. Później Google renderuje stronę, uruchamiając JavaScript, a następnie analizuje jej treść i sygnały indeksowania.
Google kolejkuje strony do renderowania, jeśli mogą być pobrane i nie blokuje ich dyrektywa robots meta ani nagłówek noindex. Renderowanie może nastąpić później, gdy zasoby Google na to pozwalają. Blokada pliku JavaScript lub zasobu potrzebnego do wyświetlenia treści może sprawić, że Google nie zobaczy kompletnej strony. Opis etapów i ograniczeń znajduje się w dokumentacji Google Search Central, sprawdzonej w październiku 2026 roku: podstawy SEO dla JavaScript.
Aplikacja typu app shell może zwrócić HTML zawierający tylko powłokę bez właściwej treści. W takim przypadku robot musi pobrać i uruchomić skrypty, aby zobaczyć tekst, nagłówki i linki generowane przez moduły. Blokada zasobów, błąd sieci albo wyjątek JavaScript może przerwać ten proces.
JavaScript nie gwarantuje ani nie wyklucza indeksacji. Dla treści ważnej w wyszukiwarce sprawdź, czy pojawia się w DOM po renderowaniu i czy linki używają elementów ``. Nie uzależniaj podstawowej treści ani nawigacji od kliknięcia, przewijania lub wypełnienia formularza. Google opisuje sposoby diagnozowania problemów w dokumentacji rozwiązywania problemów z renderowaniem JavaScript.
Które decyzje architektoniczne mają największy wpływ?
SSR, SSG, CSR i składanie na edge różnią się momentem powstania HTML oraz miejscem obsługi błędów. Tabela porównuje typowe cechy tych podejść; szczegóły zależą od implementacji i konfiguracji cache.
| Podejście | Treść w pierwszym HTML | Złożoność operacyjna | Opóźnienie treści dla użytkownika | Typowe ryzyko SEO |
|---|---|---|---|---|
| SSR | Może być kompletna dla trasy | Wysoka przy wielu zależnościach | Zależy od czasu odpowiedzi serwera | Awaria modułu może przerwać generowanie dokumentu |
| SSG | Zwykle kompletna dla wygenerowanych tras | Wymaga aktualizacji artefaktów | Niskie po dostarczeniu dokumentu | Nowa trasa może nie znaleźć się w publikacji |
| CSR | Może zawierać tylko powłokę | Wymaga kontroli skryptów klienta | Użytkownik czeka na JavaScript | Treść może nie pojawić się w renderowanym dokumencie |
| Składanie na edge | Zależy od odpowiedzi warstwy edge | Wymaga kontroli reguł i cache | Zależy od logiki i lokalizacji modułów | Cache może zwracać nieaktualną lub błędną wersję |
SSR i SSG mogą dostarczyć treść wcześniej, ale nie naprawiają automatycznie błędnych statusów, canonicali ani linków. CSR również może działać, jeśli robot ma dostęp do wymaganych zasobów i renderowanie kończy się poprawnie. Składanie na edge określa miejsce integracji, a nie gwarantowany sposób renderowania.
Wybieraj metodę dla typów tras, a nie dla całej aplikacji na podstawie jednego przykładu. Strony produktów, artykuły i kategorie często wymagają stabilnego HTML dostępnego przy wejściu bezpośrednim. Panel dostępny po zalogowaniu może mieć inne potrzeby. W sklepie opartym na rozdzielonym frontendzie porównaj wymagania z poradnikiem SEO dla WooCommerce.
Jak zachować spójne adresy, metadane i kanonicale?
Jedna uzgodniona warstwa powinna zarządzać URL, statusem HTTP i metadanymi końcowego dokumentu. Przed wdrożeniem określ, kto ustawia title, description, canonical, hreflang i dane strukturalne oraz co dzieje się, gdy moduł nie przekaże wartości.
Każda indeksowalna trasa powinna działać po bezpośrednim wejściu i odświeżeniu. Router serwera i router klienta muszą przypisywać ten sam widok do danego URL. Nieistniejąca trasa powinna zwracać właściwy błąd, a nie ogólny dokument z kodem 200 i komunikatem o braku strony. Taki soft 404 może powstać w aplikacji renderowanej po stronie klienta.
Canonical powinien wskazywać właściwą wersję treści i być zgodny z routingiem. Unikaj dwóch tagów canonical, na przykład jednego w powłoce i drugiego w module. Google ostrzega, że sprzeczne lub wielokrotne tagi canonical mogą prowadzić do nieoczekiwanych wyników; opisuje to dokumentacja SEO JavaScript.
Dla witryny wielojęzycznej ustal jednego właściciela hreflang. Dane strukturalne powinny opisywać treść konkretnej trasy, a nie być bezwarunkowo powielane przez host i moduł.
| Element | Właściciel | Warunek odbioru |
|---|---|---|
| URL i routing | Warstwa aplikacji | Trasa działa po wejściu bezpośrednim i odświeżeniu |
| Status HTTP | Serwer lub edge | Nieznany adres zwraca właściwy kod błędu |
| HTML bazowy | Host i wskazany moduł | Główna treść jest dostępna po renderowaniu |
| Metadane dokumentu | Jeden właściciel metadanych | Title, description i canonical odnoszą się do trasy |
| Linki nawigacyjne | Moduł nawigacji | Linki mają działające atrybuty href |
| Obsługa błędów | Host i właściciel modułu | Awaria nie jest maskowana jako poprawna strona |
Kontrakt z jednym właścicielem dla każdego elementu ogranicza konflikty między niezależnymi wdrożeniami.
Jak sprawdzić, czy treść jest widoczna dla robota?
Sprawdź ten sam URL w odpowiedzi HTTP, surowym HTML, DOM po wykonaniu JavaScript i teście opublikowanego adresu w Google Search Console. Zapisz adres i datę testu, aby po poprawce porównać te same warunki.
1. Pobierz URL i zanotuj status, przekierowania oraz nagłówki. Polecenie `curl -I https://example.pl/trasa` pokazuje odpowiedź nagłówkową, a `curl -L https://example.pl/trasa` pobiera dokument po przekierowaniach.
2. Otwórz kod źródłowy strony i sprawdź, czy zawiera główną treść, title, canonical oraz podstawowe linki. Widok DOM w inspektorze uwzględnia zmiany wykonane przez JavaScript, więc nie zastępuje surowego HTML.
3. W Chrome DevTools otwórz zakładkę Network, włącz Preserve log i odśwież stronę. Sprawdź statusy skryptów modułów oraz błędy w Console, w tym 404, CORS i wyjątki wykonania.
4. W Search Console otwórz Inspekcję adresu URL, uruchom test opublikowanego adresu i przejrzyj wyrenderowany HTML oraz dostępność zasobów. Google opisuje tę funkcję w pomocy dotyczącej Inspekcji adresu URL.
Sprawdź stronę główną, ważną podstronę i adres, który nie istnieje. Porównaj treść, linki i sygnały indeksowania, a potem powtórz test po zmianie powłoki, routera lub modułu metadanych. Zasady dotyczące linków dostępnych do crawlowania opisuje dokumentacja Google o linkach.
Jak diagnozować problemy z indeksacją po wdrożeniu?
Przypisz każdy problem do konkretnego URL i porównaj status HTTP, HTML, DOM po renderowaniu oraz raport Search Console. Objaw pomaga zawęzić kontrolę do warstwy, która może go powodować.
| Objaw | Pierwsza kontrola | Warstwa do sprawdzenia |
|---|---|---|
| Brak głównej treści | Wyrenderowany HTML i błędy JavaScript | Loader, SSR lub zależność API |
| Brak linków wewnętrznych | Elementy a z atrybutem href | Moduł nawigacji i router |
| Błędny canonical | Tag w HTML i końcowym DOM | Powłoka oraz moduł SEO |
| Soft 404 | Status i treść nieistniejącej trasy | Routing serwera lub edge |
| Rozbieżny title lub description | HTML początkowy i DOM końcowy | Hydratacja i właściciel metadanych |
| Stara wersja treści | Wersja modułu i cache | CDN, manifest i cache przeglądarki |
Jeśli treść widać w przeglądarce, ale nie w teście Google, sprawdź dostępność skryptów i API bez logowania oraz reguły robots.txt. Jeśli strona zwraca 200, mimo że informuje o braku treści, popraw routing i odpowiedź błędu. Gdy problem dotyczy wybranych tras, sprawdź reguły rewrite i zgodność manifestu powłoki z modułem.
Po poprawce powtórz test dla tych samych adresów i porównaj wyrenderowany HTML oraz status. Test bieżącego URL potwierdza aktualną odpowiedź, ale nie oznacza natychmiastowej zmiany w wynikach wyszukiwania.
Jak podzielić odpowiedzialność między zespoły?
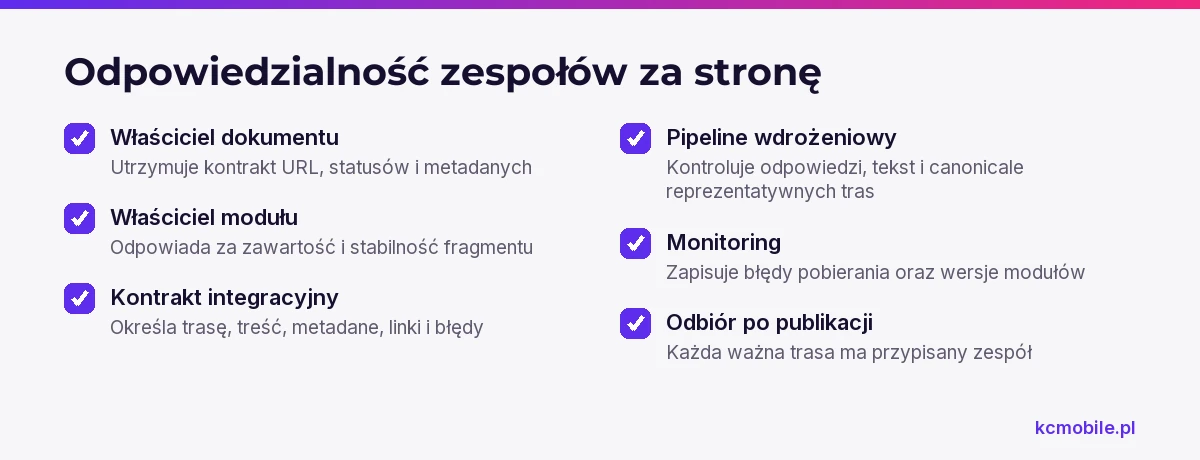
Zespół powinien wskazać jednego właściciela końcowego dokumentu, nawet gdy poszczególne fragmenty dostarczają różne zespoły. Właściciel dokumentu utrzymuje kontrakt URL, statusów i metadanych, a właściciele modułów odpowiadają za zawartość oraz stabilność swoich fragmentów.
Kontrakt powinien określać identyfikator trasy, główną treść, metadane, linki i sposób zgłaszania błędów modułu. Ustal, czy moduł może zmieniać `<head>`, jak host rozstrzyga konflikty i co użytkownik zobaczy, gdy zależność nie odpowie.
W pipeline dodaj kontrolę reprezentatywnych tras: odpowiedzi HTTP, obecności głównego tekstu i canonicala. Monitoring powinien zapisywać błędy pobierania modułów oraz wersję powłoki i modułu, aby dało się powiązać awarię z wdrożeniem. Dla każdej ważnej trasy przypisz zespół odpowiedzialny za odbiór po publikacji.
Kiedy przebudowa architektury nie jest potrzebna?
Przebudowa nie jest potrzebna tylko dlatego, że aplikacja używa CSR lub microfrontends. Jeśli ważne adresy zwracają właściwe statusy, treść jest widoczna po renderowaniu, metadane są spójne, a Search Console nie pokazuje powtarzalnych problemów, zacznij od utrzymania obecnego rozwiązania.
Dopasuj zakres naprawy do przyczyny. Błędny canonical na kilku trasach może wymagać zmiany kontraktu metadanych. Brak strony po odświeżeniu może wynikać z reguł rewrite. Powtarzalny brak treści na wielu stronach może uzasadniać zmianę metody renderowania.
| Sygnał | Pierwsze działanie | Przesłanka szerszej zmiany |
|---|---|---|
| Błędny canonical na części tras | Ustalić właściciela metadanych | Konflikt obejmuje wszystkie moduły |
| Brak strony po odświeżeniu | Poprawić reguły routingu | Model nie obsługuje stabilnych adresów |
| Treść pojawia się tylko w DOM | Zmierzyć wynik testu Google | Ważne strony regularnie nie są renderowane |
| Błędy po wydaniu modułu | Ustabilizować manifest i monitoring | Wydania powtarzalnie ukrywają treść |
W KC Mobile najpierw łączymy problem z konkretnym URL, odpowiedzią i wynikiem renderowania, a dopiero potem oceniamy koszt przebudowy. Jeśli diagnoza wskazuje na potrzebę poprawy widoczności wielu podstron, pozycjonowanie SEO może obejmować audyt techniczny i uporządkowanie priorytetów wdrożenia.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Czy microfrontends obniżają pozycje w Google?
Czy Google indeksuje aplikacje micro frontend renderowane po stronie klienta?
Czy microfrontends wymagają SSR dla SEO?
Jak ustawić canonicale w architekturze microfrontends?
Jak sprawdzić, czy Google widzi treść aplikacji JavaScript?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Wpływ microfrontends na SEO: renderowanie, indeksacja i testy”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.