Gdy klienci nie mogą szybko znaleźć kategorii, produktu lub usługi, przyczyną może być sposób uporządkowania serwisu. Rozrastający się katalog, filtry i synchronizacja z ERP potrafią tworzyć podobne adresy oraz strony bez użytecznej drogi wejścia.
Krótka odpowiedź
Zacznij od inwentaryzacji adresów, oferty i danych Google Search Console, a następnie przypisz każdej grupie zapytań intencję, typ strony i miejsce w hierarchii. Dla każdego URL-a określ jego rolę, adres docelowy, status indeksowania i linki wewnętrzne.
Przed publikacją przetestuj mapę przekierowań, filtry oraz synchronizację ERP, a po wdrożeniu sprawdzaj indeksowanie i ruch dla ważnych grup adresów.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Jak tworzyć architekturę informacji, która wspiera SEO techniczne”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czym jest architektura informacji i co ma wspólnego z SEO technicznym?
Architektura informacji porządkuje treści i relacje między stronami, aby użytkownik rozumiał, gdzie jest i dokąd może przejść. W SEO technicznym wpływa na odkrywanie adresów przez roboty, dostępność treści oraz rozpoznanie, które strony pełnią podobne funkcje.
Architektura, URL, nawigacja i linkowanie wewnętrzne opisują różne warstwy serwisu. Architektura określa hierarchię treści, URL jest adresem konkretnej strony, nawigacja prowadzi użytkownika po serwisie, a linki wewnętrzne łączą strony. Powinny wspierać ten sam model, ale nie muszą być identyczne: poradnik może być osiągalny z kategorii przez link kontekstowy bez miejsca w głównym menu.
Głębokość kliknięć to liczba przejść od strony wejściowej do danego adresu. Nie ma jednej liczby właściwej dla każdego serwisu, ale ważna kategoria bez logicznej drogi z nawigacji wymaga sprawdzenia. Osierocony adres nie ma linków wewnętrznych prowadzących do niego; obecność w sitemapie XML nie zastępuje ścieżki nawigacyjnej.
Duplikacja ścieżek występuje, gdy podobna treść działa pod kilkoma URL-ami, na przykład przez parametry sortowania lub alternatywne warianty kategorii. Wtedy ustal, który adres jest główny, czy pozostałe mają przekierowywać, wskazywać canonical, czy pozostać dostępne bez indeksowania. Canonical to sygnał wskazujący preferowany adres dla stron z duplikującą się lub bardzo podobną treścią; Google może wybrać inny adres niż wskazany przez właściciela. Google opisuje metody wskazywania adresu kanonicznego.
`noindex` to dyrektywa w znaczniku meta lub nagłówku HTTP, która informuje Google, że strona nie powinna pojawiać się w wynikach. Robot musi móc pobrać stronę, aby odczytać tę dyrektywę; blokada w robots.txt może uniemożliwić odczytanie `noindex`. Dokumentacja Google wyjaśnia działanie noindex i jego ograniczenia. Szczegóły optymalizacji pojedynczej strony opisujemy w poradniku on-page SEO i optymalizacji strony.
Czytasz poradnik „Jak tworzyć architekturę informacji, która wspiera SEO techniczne”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Od czego zacząć projektowanie struktury serwisu?
Projektowanie struktury zaczyna się od danych o istniejących stronach, ofercie i ograniczeniach wdrożenia, a nie od rysowania menu. Taka kolejność pozwala rozpoznać, czy problem dotyczy hierarchii, treści, linków, statusu odpowiedzi HTTP czy konfiguracji CMS.
Zbierz adresy z crawla, sitemap XML, Google Search Console, analityki oraz eksportów CMS i ERP. Dla każdego URL-a zachowaj tytuł, typ strony, status HTTP, indeksowalność, canonical oraz liczbę linków wewnętrznych. Google Search Console opisuje raport Skuteczność, który pokazuje między innymi zapytania i strony wraz z kliknięciami oraz wyświetleniami. Narzędzie Sprawdzanie adresu URL pozwala sprawdzić, co Google wie o konkretnym adresie i przetestować jego bieżącą wersję; instrukcja Google prowadzi przez kontrolę pojedynczej strony.
Następnie połącz adresy z katalogiem produktów, usługami i tematami treści. Oznacz wycofane strony, duplikaty, warianty z parametrami oraz adresy widoczne w linkach lub raportach, których nie ma już w CMS. Zapisz też właściciela danych: jeśli ERP zarządza nazwą produktu, a CMS slugiem, określ to w specyfikacji i sprawdź, czy import nie nadpisze ręcznej zmiany.
Po inwentaryzacji pogrupuj zapytania według potrzeby użytkownika. Zapytanie o zakup, porównanie i instrukcję doboru może dotyczyć tego samego produktu, ale wymagać innego typu strony. Zapisz ograniczenia CMS, ERP, filtrów, paginacji, przekierowań i czasu zespołu przed akceptacją docelowego modelu.
Przetestuj model na fragmencie zawierającym kategorię, podkategorię, produkt, filtr i artykuł. Sprawdź, czy ERP zachowuje przypisania oraz czy CMS pozwala ustawić tytuły, slugi, canonicale i reguły indeksowania. Jeśli potrzebujesz zespołu do przełożenia analizy na plan prac, pozycjonowanie SEO KC Mobile obejmuje prace nad widocznością i technicznymi podstawami serwisu.
Jak pogrupować treści i kategorie?
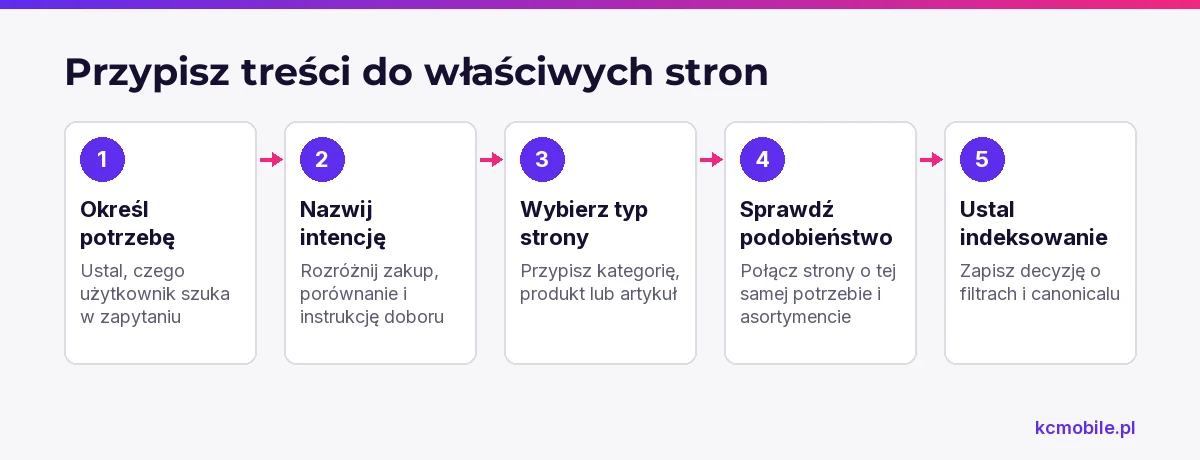
Treści i kategorie grupujemy według potrzeby użytkownika, a słów kluczowych używamy do sprawdzenia, jak użytkownicy tę potrzebę nazywają. Podobieństwo fraz nie przesądza o wspólnym URL-u: wybór produktu, porównanie modeli i instrukcja doboru wymagają innych odpowiedzi.
Dla każdej grupy zapytań określ temat, intencję i jeden docelowy typ strony. Jeśli dwie planowane strony miałyby odpowiadać na te same pytania i prezentować ten sam asortyment, rozważ połączenie ich albo wyraźne rozdzielenie zakresu. Strony filtrów oceniaj oddzielnie, bo ich przydatność dla kupującego nie oznacza automatycznie, że powinny być indeksowane.
Przypisz grupie zapytań jedną stronę odpowiadającą na jej intencję. Ryzyko kanibalizacji oznacza tu ryzyko, że podobne strony będą konkurować o te same zapytania.
| Grupa zapytań | Typ strony | Poziom w strukturze | Ryzyko kanibalizacji |
|---|---|---|---|
| buty trekkingowe damskie | Kategoria | 1 | Niskie przy odrębnym asortymencie |
| buty trekkingowe damskie niskie | Podkategoria | 2 | Średnie przy podobnym asortymencie |
| jak dobrać buty trekkingowe | Artykuł poradnikowy | Treść wspierająca | Średnie przy braku rozdziału intencji |
| buty trekkingowe model X | Karta produktu | Produkt w kategorii | Niskie przy opisie konkretnego modelu |
| buty trekkingowe damskie rozmiar 39 | Wynik filtrowania | Parametr filtra | Wysokie przy indeksowaniu każdej kombinacji |
Ryzyko wzrasta, gdy strony odpowiadają na tę samą potrzebę i pokazują zbliżony zestaw produktów.
Silos tematyczny to organizacja powiązanych treści wokół wspólnego tematu. Użyteczny silos ma stronę nadrzędną, strony szczegółowe i linki ułatwiające przejście między tematami. Nie wymaga tworzenia osobnych katalogów URL ani blokowania linków między działami.
Przed utworzeniem kategorii sprawdź jej zawartość, rolę w zakupie i różnicę wobec istniejących stron. Kategoria z własnym asortymentem i zakresem może odpowiadać na odrębną potrzebę; kombinacja filtrów z niemal identyczną listą produktów może nie uzasadniać osobnego adresu. Zapisz decyzję o indeksowaniu i canonicalu w arkuszu struktury.
Jak zaplanować hierarchię i głębokość kluczowych stron?
Hierarchię budujemy od głównych obszarów oferty do szczegółowych grup, dodając poziom wtedy, gdy ułatwia nawigację i odpowiada odrębnej potrzebie. Dodatkowe słowa kluczowe same w sobie nie uzasadniają nowej kategorii.
Przykładowe drzewo sklepu:
Sklep
└── Obuwie
    └── Buty trekkingowe
        ├── Damskie
        ├── Męskie
        └── Akcesoria do pielęgnacji
Każdy poziom oceń pod kątem odrębnego asortymentu lub treści, oczekiwań klienta i samodzielnej wartości strony. Jeśli podkategoria zawiera te same produkty co strona nadrzędna i nie odpowiada na osobną potrzebę, rozważ filtr zamiast nowej strony indeksowalnej.
Główna nawigacja powinna udostępniać najważniejsze obszary oferty i treści potrzebne do decyzji. Nie musi zawierać każdego produktu ani artykułu. Strony szczegółowe łącz przez okruszki, linki z kategorii, sekcje powiązanych treści i odnośniki kontekstowe. Okruszki pokazują użytkownikowi pozycję strony w hierarchii, nawet jeśli URL jest krótszy niż pełna ścieżka.
Dla każdego URL-a zapisz stronę nadrzędną, intencję, typ, indeksowalność i planowane linki. Crawlerem zmierz głębokość od strony startowej, ale oceniaj ją w kontekście roli adresu. Ważna kategoria powinna mieć widoczne wejście z menu lub kategorii nadrzędnej; artykuł może być dostępny z linku w poradniku.
Sprawdź również, czy szablon publikuje linki HTML z atrybutem `href`, a nie wyłącznie akcje uruchamiane przez JavaScript. Google odkrywa adresy przede wszystkim przez linki, dlatego dokumentacja Google omawia linki możliwe do crawlowania.
Jak dobrać adresy URL i linki wewnętrzne do struktury?
URL powinien być stabilny, czytelny i przypisany do jednej strony. Zmiana nazwy w menu nie musi oznaczać zmiany adresu, a przed zmianą sluga trzeba sprawdzić linki, canonical, sitemapę, ERP i odnośniki zewnętrzne.
Ustal jednolite zasady zapisu: małe litery, sposób zapisu polskich znaków, krótkie slugi i rozdzielanie wyrazów dywizem. Unikaj adresów zmienianych przy każdym imporcie i technicznych identyfikatorów niezrozumiałych dla użytkownika. Więcej o technicznej stronie adresów opisujemy w poradniku Technical SEO i optymalizacji technicznej.
Link wewnętrzny powinien prowadzić do działającego adresu docelowego, a anchor wyjaśniać, dokąd prowadzi. W menu, okruszkach i kartach kategorii sprawdzaj, czy szablon generuje zwykły link HTML. Link w sitemapie XML pomaga robotowi odkryć adres, ale nie zastępuje ścieżki nawigacyjnej.
Przypisz każdemu staremu adresowi odpowiedni cel i działanie. Adres powinien prowadzić do równoważnej strony albo otrzymać status odpowiadający usunięciu treści.
| Stary URL | Nowy URL | Status starego adresu | Działanie |
|---|---|---|---|
| `/buty/trekkingowe-damskie/` | `/obuwie/trekkingowe/damskie/` | 301 | Przekieruj i popraw linki |
| `/obuwie/?plec=damskie` | `/obuwie/damskie/` | Zależny od roli parametru | Zweryfikuj równoważność asortymentu |
| `/poradnik/stare-buty/` | - | 404 albo 410 po weryfikacji | Usuń linki i wpis z mapy witryny |
Przykładowe adresy pokazują różne przypadki; nowy adres damskiego obuwia powinien odpowiadać całemu asortymentowi, a nie tylko butom trekkingowym.
Przekierowanie 301 stosuj, gdy stary adres zastępujesz konkretnym odpowiednikiem. Nie kieruj wszystkich usuniętych stron na stronę główną. Po zmianie zaktualizuj menu, treści, okruszki, canonicale i sitemapę, aby linki wewnętrzne prowadziły bezpośrednio do nowych adresów.
Canonical służy do wskazania preferowanego adresu dla stron podobnych, ale nie zastępuje przekierowania, gdy stary URL ma przestać działać. Sprawdź, czy strona docelowa ma zgodną zawartość; nie kieruj ogólnego filtra obuwia damskiego do węższej kategorii trekkingowej. Google wyjaśnia relację między canonicalem, przekierowaniem i sitemapą.
Jak sprawdzić strukturę przed wdrożeniem?
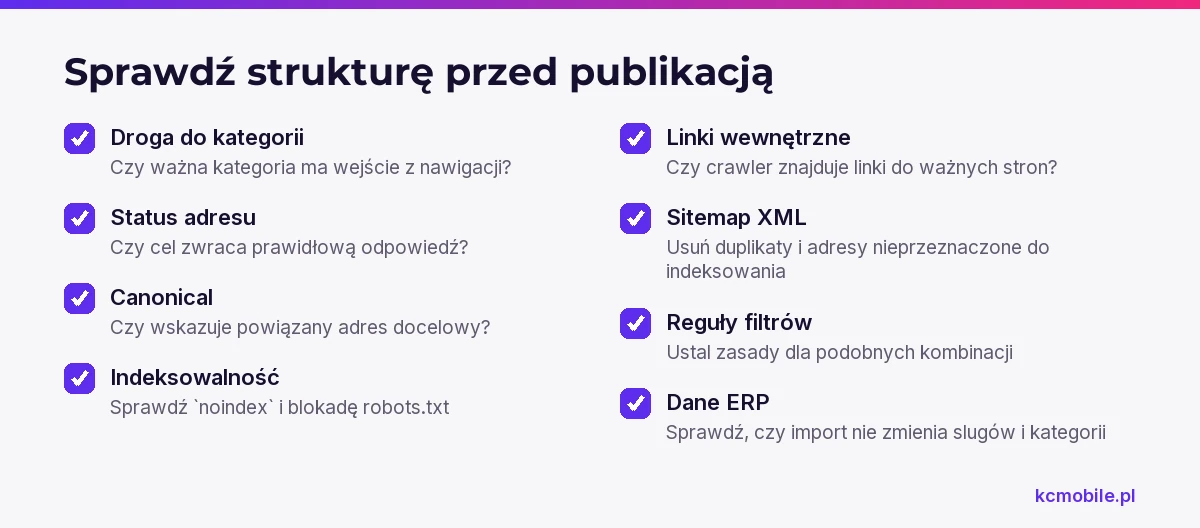
Przed publikacją crawluj wersję testową i sprawdź adresy, ich połączenia oraz reguły indeksowania. Crawler, taki jak Screaming Frog SEO Spider, może zebrać statusy HTTP, canonicale, linki wewnętrzne i głębokość kliknięć, jeśli dostęp i ustawienia crawla obejmują staging.
Zestaw crawl z sitemapą, eksportem CMS i regułami ERP, aby wykryć rozbieżności przed publikacją.
| Kontrola | Sygnał problemu | Działanie przed publikacją |
|---|---|---|
| Liczba kliknięć | Ważna kategoria nie ma drogi z nawigacji | Dodaj link z kategorii nadrzędnej |
| Status HTTP | Adres docelowy zwraca 404 lub 5xx | Popraw cel albo mapę przekierowań |
| Canonical | Wskazuje adres niepowiązany lub przekierowujący | Uzgodnij canonical z zawartością |
| Indeksowalność | Ważna strona ma `noindex` lub blokadę robots.txt | Sprawdź meta robots i robots.txt |
| Linki przychodzące | Crawler nie znajduje linków do adresu | Dodaj link albo usuń zbędną stronę |
| Sitemap XML | Zawiera duplikaty, przekierowania lub strony `noindex` | Zostaw adresy kanoniczne przeznaczone do indeksowania |
| Filtry sklepu | Kombinacje tworzą podobne adresy bez własnej wartości | Ustal reguły dla każdej grupy filtrów |
| Dane ERP | Import zmienia slugi lub przypisania kategorii | Ustal źródło prawdy i sprawdź import |
Wartości w kolumnie sygnału problemu wskazują przypadki do weryfikacji, a nie automatyczne rozstrzygnięcie.
Robots.txt i `noindex` pełnią różne funkcje: robots.txt ogranicza crawlowanie, a `noindex` zabrania wyświetlania strony w wynikach po odczytaniu dyrektywy. Jeśli robots.txt blokuje URL, Google może nie odczytać `noindex`. Google opisuje robots.txt i techniczne wymagania indeksowania.
Sitemap XML powinna zawierać adresy, które mają pojawiać się w wynikach, zwykle adresy kanoniczne. Google nie traktuje mapy witryny jako gwarancji indeksowania, a sama obecność adresu w pliku nie naprawia błędnego statusu ani braku linków. Google opisuje zasady budowy i przesyłania sitemap.
Typowe problemy wykrywaj przez porównanie crawla, CMS, Search Console i katalogu ERP. Płaskie menu może utrudniać rozpoznanie grup oferty, puste kategorie mogą nie wnosić samodzielnej wartości, a indeksowane filtry tworzą podobne adresy. Diagnozuj każdy przypadek przez sprawdzenie zawartości strony, jej linków, statusów i reguł indeksowania. Dalsze testy opisuje checklista audytu SEO.
Perspektywa KC Mobile
Przy integracji sklepu warto sprawdzić, czy import ERP nie przywraca starych slugów, nie zmienia przypisań kategorii i nie publikuje stron bez produktów. Test reprezentatywnego importu na środowisku testowym pozwala ocenić wpływ reguł synchronizacji przed zastosowaniem ich do całego katalogu.
Jak wdrożyć zmiany bez utraty ruchu organicznego?
Zmiany wdrażaj na podstawie zatwierdzonej mapy URL-i oraz procedury wycofania publikacji. Mapa powinna przypisywać każdemu staremu adresowi konkretny cel, status, canonical i właściciela zmiany.
Przygotuj kopię obecnych adresów, statusów, canonicali, kliknięć, wyświetleń i linków wewnętrznych jako punkt odniesienia. Następnie odtwórz model na środowisku testowym z konfiguracją CMS, szablonów i ERP. Zablokuj indeksowanie stagingu i upewnij się, że jego canonicale nie trafią na produkcję.
Dla każdego starego adresu zdecyduj, czy pozostaje, przekierowuje do odpowiednika, zwraca 404 lub 410, czy wskazuje właściwy canonical. Przetestuj parametry filtrów i warianty adresów, w tym kolejność parametrów oraz działanie czyszczenia filtrów. Dla integracji porównaj slug, przypisanie kategorii, status publikacji i kompletność danych przed importem oraz po nim.
Przed publikacją wykonaj crawl stagingu i usuń pętle przekierowań, błędne odpowiedzi, niezgodne canonicale oraz linki prowadzące do starych adresów. Zapisz warunki akceptacji, na przykład: stary URL produktu zwraca 301 do nowej karty, linki wewnętrzne prowadzą bezpośrednio do celu, a sitemap XML zawiera nowy adres kanoniczny.
Po publikacji sprawdź logi serwera pod kątem powtarzających się żądań do starych adresów, odpowiedzi 404 i 5xx oraz wizyt Googlebota. W Google Search Console użyj Sprawdzania adresu URL dla reprezentatywnych stron z każdej grupy. Narzędzie pokazuje dane z indeksu Google i pozwala uruchomić test na żywo; Google opisuje zakres kontroli pojedynczego URL-a.
Monitoruj stare i nowe adresy osobno, bo łączny ruch serwisu może ukryć problem pojedynczej kategorii. Porównuj indeksowanie oraz skuteczność dla tych samych grup URL-i i okresów. Google nie gwarantuje zachowania konkretnej pozycji po zmianie struktury; jeśli mapa prowadzi do niewłaściwej strony albo tworzy pętlę, popraw regułę i ponownie sprawdź całą ścieżkę. Jeśli potrzebujesz wsparcia przy analizie i wdrożeniu, usługi pozycjonowania SEO KC Mobile obejmują prace nad techniczną podstawą widoczności serwisu.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Jak ocenić, czy kategoria ma własną wartość dla użytkownika?
Czy ważny URL może być poza głównym menu?
Czy można indeksować wszystkie kombinacje filtrów w sklepie?
Jak sprawdzić, czy ERP nadpisuje zmiany SEO?
Czy sitemap XML wystarczy, aby Google znalazł ważną stronę?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Jak tworzyć architekturę informacji, która wspiera SEO techniczne”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.