Adresy z parametrami powstają przy kampaniach, filtrowaniu, sortowaniu i wyborze wariantów produktów. Sam znak zapytania w adresie nie oznacza problemu SEO, ale niekontrolowane kombinacje filtrów mogą tworzyć wiele stron do crawlowania. Diagnozę zaczynamy od sprawdzenia, co parametr zmienia dla użytkownika i robota Google.
Krótka odpowiedź
Dawne narzędzie Parametry w URL-ach w Google Search Console zostało wycofane w 2022 roku. Dziś sprawdzaj konkretne adresy w narzędziu do sprawdzania adresów URL i raportach indeksowania, a sposób obsługi parametrów wdrażaj na stronie lub serwerze.
Canonical wskazuje preferowany adres podobnej strony, noindex wyklucza dostępną stronę z indeksu, przekierowanie scala adresy, a robots.txt ogranicza crawlowanie.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Zarządzanie parametrami URL: co dziś można sprawdzić w Search Console”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czy Search Console ma narzędzie do zarządzania parametrami URL?
Google Search Console nie udostępnia już dawnego narzędzia Parametry w URL-ach do definiowania wpływu parametrów na crawlowanie. Google ogłosiło jego wycofanie 28 marca 2022 roku, a dawne instrukcje przechodzenia do tego menu nie opisują aktualnej funkcji Search Console. Informacja o wycofaniu znajduje się w komunikacie Google Search Central.
Search Console nadal pomaga diagnozować pojedyncze adresy i sprawdzać ich stan indeksowania. Narzędzie do sprawdzania adresów URL pokazuje dane znanej Google wersji strony oraz pozwala przetestować bieżącą wersję pod kątem dostępności i możliwości indeksowania. Raporty indeksowania pokazują problemy wykryte przez Google, ale nie zawierają pola do ustawiania reguł dla `sort`, `filter` lub `utm_source`.
Reguły obsługi parametrów wdraża się w kodzie strony, konfiguracji serwera albo pliku robots.txt, zależnie od celu. Canonical wskazuje preferowaną wersję podobnej strony, noindex informuje Google, że dostępna strona nie ma znaleźć się w wynikach, a przekierowanie przenosi użytkownika i robota pod inny adres.
Przy większym serwisie kontrolę adresów warto połączyć z pozycjonowaniem SEO strony lub sklepu, ponieważ decyzje o parametrach wpływają na indeksowanie i architekturę widoczności. Nie należy mylić diagnozy w Search Console z wdrożeniem reguły, które wymaga zmian na stronie lub serwerze.
Czytasz poradnik „Zarządzanie parametrami URL: co dziś można sprawdzić w Search Console”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak rozpoznać, które parametry zmieniają treść strony?
Parametr zmieniający zestaw produktów, kolejność lub wariant może tworzyć inną wersję strony, a parametr kampanii zwykle opisuje źródło wizyty. Oceniaj rzeczywisty rezultat adresu, a nie samą nazwę parametru.
Tabela pokazuje typowe funkcje parametrów oraz ryzyko, które warto sprawdzić przed wyborem metody obsługi. Ten sam parametr może działać inaczej w dwóch sklepach, dlatego porównaj stronę przed zastosowaniem parametru i po nim.
| Typ parametru | Zmienia treść lub kolejność? | Ryzyko do sprawdzenia |
|---|---|---|
| UTM | Zwykle nie | Linki wewnętrzne prowadzą do wersji z UTM |
| Sortowanie | Zmienia kolejność | Powstają warianty listy bez odrębnej wartości |
| Filtr | Może zmieniać zestaw produktów | Wartościowa strona miesza się ze zbędnymi kombinacjami |
| Paginacja | Zmienia wyświetlany zestaw | Linki do kolejnych stron działają spójnie |
| Wariant produktu | Może zmieniać ofertę lub cechy | Wariant ma właściwy adres kanoniczny |
| Sesja | Zwykle nie | Każda wizyta tworzy nowy adres |
| Wyszukiwanie | Zmienia wyniki zapytania | Powstaje wiele stron o małej wartości |
Parametr UTM, na przykład `utm_source=newsletter`, zwykle mierzy źródło kampanii i nie zmienia treści strony. Parametr `kolor=czarny` może natomiast ograniczyć ofertę do konkretnego zestawu produktów, więc trzeba ocenić unikalność, popyt i linkowanie tej strony.
Sortowanie zmienia kolejność produktów, ale nie zawsze zmienia ich skład. Jeśli sklep generuje adres dla każdej kolejności, sprawdź, czy linki wewnętrzne, mapa witryny i canonical wskazują zamierzoną wersję kategorii. Parametr sesji sprawdź także pod kątem unikalnych wartości tworzonych dla kolejnych użytkowników.
Jak sprawdzić adres z parametrem w Search Console?
Narzędzie do sprawdzania adresów URL kontroluje pełny adres należący do aktualnie otwartej usługi Search Console. Wklej adres wraz z parametrem do paska inspekcji, a następnie sprawdź wynik indeksowania, dostępność do crawlowania i adres kanoniczny.
Wynik indeksu Google opisuje wersję poznaną podczas ostatniego crawlowania, więc może nie uwzględniać najnowszej zmiany na stronie. Test wersji opublikowanej sprawdza bieżącą dostępność i wybrane warunki indeksowania, ale nie przewiduje wyboru canonical przez Google. Dokumentacja Search Console wskazuje, że canonical wybrany przez Google można odczytać w danych indeksu, a nie w wyniku testu na żywo.
Kontrola przykładowego adresu przebiega tak:
1. Otwórz właściwą usługę domeny lub prefiksu URL w Search Console.
2. Wklej pełny adres z parametrem do paska inspekcji na górze ekranu.
3. Sprawdź, czy adres jest znany Google i jaki status indeksowania pokazuje raport.
4. Rozwiń informacje o crawlowaniu i sprawdź, czy Google mógł pobrać stronę.
5. Porównaj canonical zadeklarowany przez witrynę z canonical wybranym przez Google.
6. Uruchom test adresu na żywo po zmianie strony, nagłówków lub reguł indeksowania.
Adres musi należeć do aktualnie wybranej usługi. Test na żywo nie pokazuje ostatecznego wyboru canonical, a Search Console ogranicza liczbę inspekcji dostępnych dla usługi w ciągu doby. Z tego powodu sprawdzaj reprezentatywne adresy z każdej grupy parametrów zamiast próbować inspekcji wszystkich kombinacji filtrów.
Inspekcja służy do diagnozy konkretnych adresów, a nie do masowego ustawiania reguł dla całej rodziny parametrów. Przy większej skali zestaw próbkę adresów z raportami indeksowania i logami serwera.
Jak ograniczyć duplikaty tworzone przez parametry?
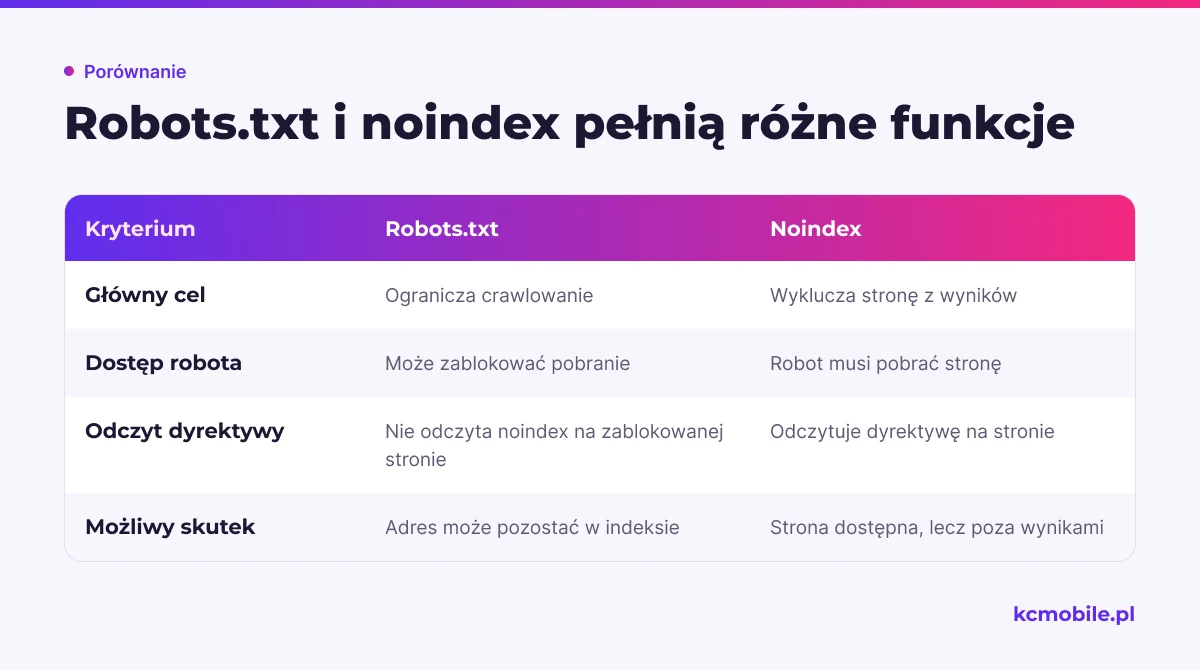
Dobierz metodę do funkcji wariantu: canonical wskazuje preferowany adres podobnej strony, przekierowanie scala adresy, a noindex wyłącza dostępną stronę z wyników. Robots.txt ogranicza crawlowanie, ale nie zastępuje dyrektywy noindex.
Tabela pomaga wybrać punkt wyjścia dla typowej sytuacji. Przed wdrożeniem sprawdź odpowiedź serwera, linkowanie wewnętrzne i to, czy parametr jest potrzebny użytkownikowi.
| Metoda | Kiedy ją stosować | Główne ograniczenie |
|---|---|---|
| Canonical | Podobny wariant ma wskazywać główny adres | Google może wybrać inny adres kanoniczny |
| Przekierowanie | Wariant adresu nie powinien działać osobno | Może usunąć funkcję potrzebną użytkownikowi |
| Noindex | Strona ma działać, ale nie ma być w wynikach | Robot musi móc pobrać stronę i odczytać dyrektywę |
| Robots.txt | Trzeba ograniczyć crawlowanie wzorca URL | Google nie odczyta zablokowanej strony |
| Pozostawienie adresu | Parametr tworzy użyteczną, unikalną stronę | Trzeba kontrolować liczbę i jakość stron |
Canonical jest sygnałem preferowanego adresu, a nie gwarancją wyboru Google. Linki wewnętrzne, przekierowania, canonical i mapa witryny powinny wskazywać tę samą wersję, jeśli taki jest zamierzony rezultat.
Noindex i robots.txt rozwiązują różne problemy. Noindex wymaga, aby robot mógł pobrać stronę i odczytać dyrektywę, natomiast robots.txt może zablokować samo pobranie. Zasady canonicalizacji i dyrektyw indeksowania opisuje dokumentacja Google Search Central.
Jak traktować parametry filtrów i sortowania w sklepie?
Indeksuj filtr, gdy tworzy użyteczną stronę z odrębną ofertą i odpowiada na konkretne zapytanie użytkownika. Ogranicz kombinacje, które tylko przestawiają lub zawężają te same produkty bez dodatkowej wartości dla wyszukiwarki.
Zacznij od rodzin filtrów, a nie od pojedynczych adresów. Dla marki, rodzaju produktu lub istotnej cechy sprawdź, czy wynik ma stabilny adres, dostatecznie odrębną ofertę i popyt uzasadniający samodzielną stronę. Ustal również, czy użytkownik może dotrzeć do strony przez linki wewnętrzne i czy jej zawartość różni się od kategorii nadrzędnej.
Dla kombinacji bez popytu i unikalności ogranicz niekontrolowane tworzenie adresów dostępnych dla robota. Sklep może generować wiele URL-i przez łączenie koloru, rozmiaru, dostępności, sortowania i paginacji. Zespół powinien określić dopuszczalne kolejności parametrów, zachowanie pustych wyników oraz kombinacje, które otrzymają stabilne linki.
Google opisuje nawigację fasetową jako źródło dużej liczby możliwych adresów i zwiększonego crawlowania. Dokumentacja zaleca między innymi spójny format parametrów i odpowiedź HTTP 404 dla kombinacji bez wyników. Adres pustego filtra nie powinien automatycznie przekierowywać do ogólnej strony błędu, jeśli serwis może zwrócić właściwą odpowiedź dla tej kombinacji.
Z naszych wdrożeń wynika, że decyzję o indeksowaniu należy podejmować osobno dla rodzin filtrów. Filtr marki może tworzyć użyteczną stronę, podczas gdy połączenie rozmiaru, koloru, sortowania i dostępności może mnożyć adresy o niemal identycznej wartości.
Kiedy użyć robots.txt, a kiedy nie?
Użyj robots.txt do ograniczenia crawlowania wzorca adresów, gdy nie chcesz, aby robot regularnie pobierał niepotrzebne kombinacje filtrów. Nie używaj robots.txt jako metody usuwania adresu z indeksu.
Robot zablokowany przez robots.txt nie pobierze strony, więc nie odczyta umieszczonego na niej noindex ani canonical. Adres może nadal pojawić się w wynikach, jeśli Google znajdzie go przez inne linki. Google wskazuje, że do wykluczenia dostępnej strony z wyników należy użyć noindex, a robot musi móc pobrać stronę, aby odczytać tę regułę.
Przed blokadą sprawdź, czy wzorzec nie obejmuje wartościowych stron, ważnych plików ani zasobów potrzebnych do renderowania. Reguła dla `?filter=` może objąć zarówno zbędne kombinacje, jak i adresy stron, które mają pozyskiwać ruch. Przetestuj przykładowe adresy i porównaj je z listą stron przeznaczonych do indeksowania.
Robots.txt steruje dostępem robota do adresów, a nie oceną wartości strony. Jeśli celem jest ograniczenie liczby żądań do ogromnej liczby filtrów, blokada może być właściwa. Jeśli strona ma pozostać dostępna dla Google, ale nie powinna pojawiać się w wynikach, użyj metody pozwalającej robotowi odczytać noindex.
Jak monitorować wpływ zmian w adresach?
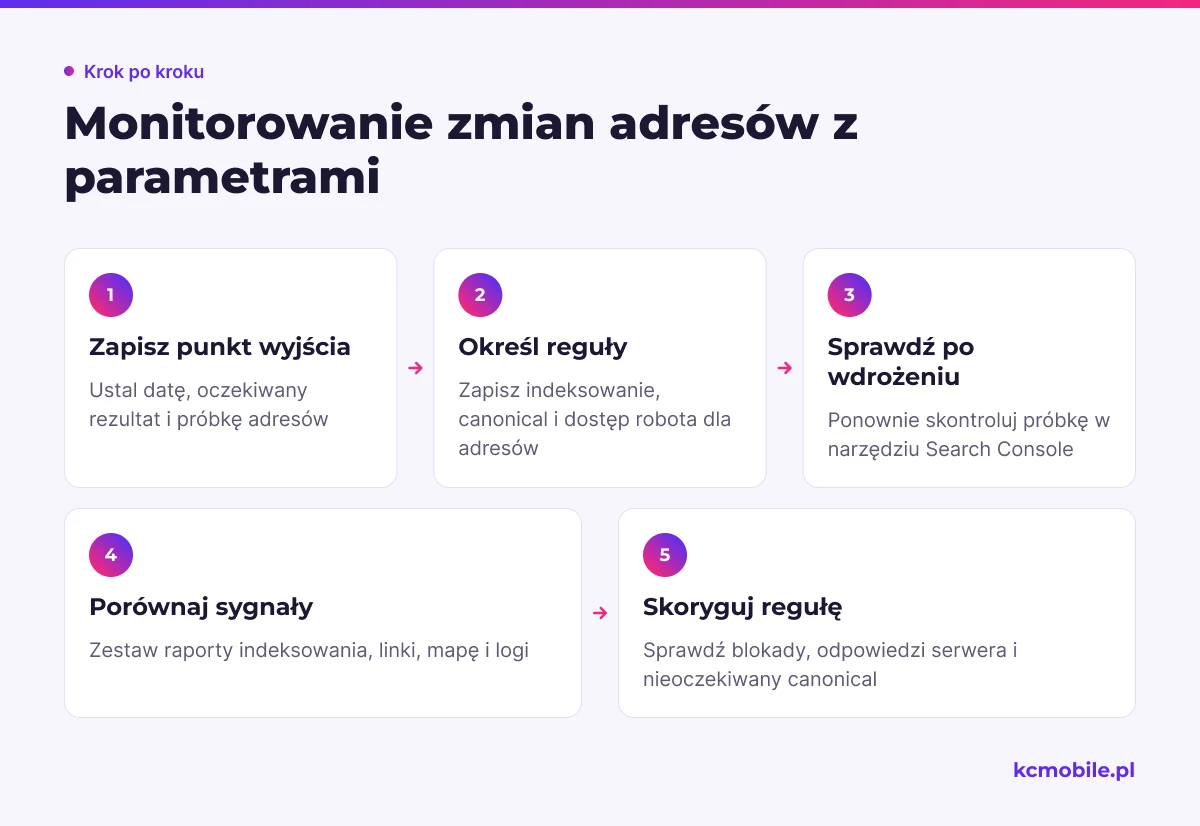
Porównuj te same reprezentatywne grupy adresów przed zmianą i po niej, kontrolując indeksowanie, canonical, crawlowanie oraz ruch organiczny. Sama zmiana liczby adresów w raporcie nie dowodzi poprawy ani pogorszenia widoczności.
Zapisz datę wdrożenia, oczekiwany rezultat i próbkę adresów bez parametrów oraz z UTM, sortowaniem, ważnym filtrem i kombinacją filtrów. Dla każdego adresu określ, czy ma być indeksowany, jaki canonical powinien wskazywać i czy robot powinien go pobierać. Dodaj adres z pustym wynikiem, jeśli sklep takie adresy generuje.
Po wdrożeniu ponownie sprawdź wybrane adresy w narzędziu do sprawdzania adresów URL. Porównaj wyniki z raportami indeksowania, linkami wewnętrznymi i mapą witryny. Jeśli masz logi serwera, sprawdź, czy Googlebot odwiedza pożądane grupy adresów i czy nie wykonuje nadmiernej liczby żądań do kombinacji bez wartości.
Jeśli ważne strony przestają być crawlowane albo Google wybiera nieoczekiwany canonical, sprawdź kolejno robots.txt, dostępność dyrektyw, odpowiedzi serwera, canonical i linkowanie. Skoryguj regułę, jeśli blokada obejmuje wartościowe adresy albo ogranicza dostęp do potrzebnej treści. Zapis daty i próbki ułatwia odróżnienie skutku wdrożenia od sezonowości ruchu.
Jakich starych porad o parametrach URL unikać?
Unikaj porad, które każą konfigurować parametry w wycofanym URL Parameters Tool albo zakładają, że każda wartość parametru automatycznie tworzy duplikat. Google wycofało narzędzie w 2022 roku, więc jego ustawień nie można dziś użyć do sterowania crawlowaniem.
Nie kopiuj reguły robots.txt bez sprawdzenia wzorca na adresach sklepu. Instrukcja blokująca wszystkie strony z parametrem może objąć wartościowe filtry albo adresy potrzebne Google do odkrywania produktów. Sama blokada nie gwarantuje usunięcia tych URL-i z indeksu.
Zastąp starą instrukcję aktualną kontrolą: określ funkcję parametru, sprawdź reprezentatywny adres, oceń różnicę treści i wybierz właściwy sygnał na stronie lub serwerze. Przed publikacją zmiany sprawdź zgodność canonical, linków wewnętrznych, mapy witryny i robots.txt.
Przy większym serwisie możemy połączyć porządkowanie parametrów z planem pozycjonowania SEO, obejmującym ocenę indeksowania i priorytety stron. W bazie wiedzy opisujemy też narzędzia SEO i ich ograniczenia oraz inspekcję adresu własnej strony.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Czy w Google Search Console można dziś zarządzać parametrami URL?
Co zastąpiło narzędzie URL Parameters w Search Console?
Czy parametry UTM tworzą duplikaty treści?
Jak zablokować indeksowanie filtrów w sklepie internetowym?
Czy robots.txt usuwa adres z parametrem z indeksu Google?
Czy canonical gwarantuje, że Google wybierze wskazany adres?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Zarządzanie parametrami URL: co dziś można sprawdzić w Search Console”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.