Strona może działać poprawnie dla użytkownika, a mimo to nie pojawić się w wynikach wyszukiwania. Diagnoza wymaga ustalenia, czy Google zna adres URL, może go pobrać, rozumie jego treść i wybrał go do indeksu.
Krótka odpowiedź
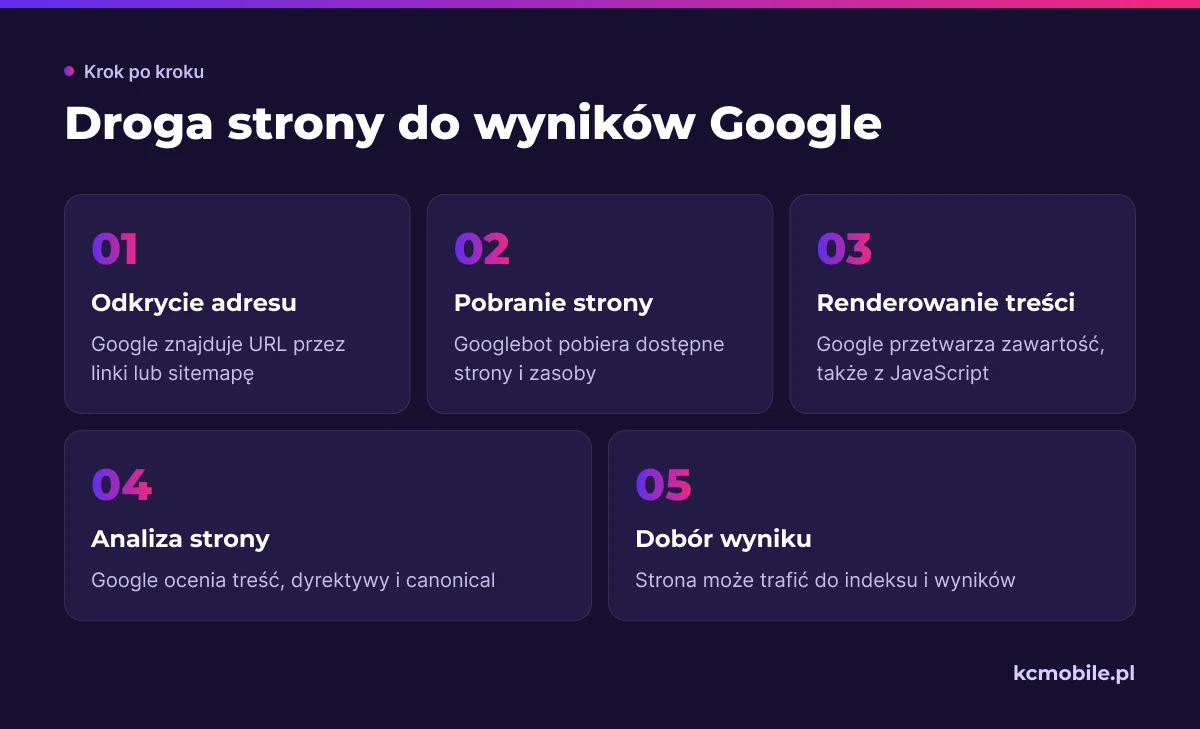
Google odkrywa adres URL przez linki lub sitemapę, crawluje stronę za pomocą Googlebota, renderuje jej zawartość i analizuje ją przed ewentualnym dodaniem do indeksu. Crawlowanie oznacza pobranie strony, indeksowanie oznacza analizę i zapis informacji, a wyświetlenie wyniku następuje dopiero przy zapytaniu pasującym do strony.
Żaden etap nie gwarantuje kolejnego, dlatego status diagnozuj w raportach Indeksowanie stron i narzędziu Sprawdzanie adresu URL w Google Search Console.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Jak działa indeksowanie w wyszukiwarce Google? Etapy i diagnostyka”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czym jest indeksowanie strony w Google?
Indeksowanie strony w Google to analiza jej treści i zapis informacji w indeksie, z którego wyszukiwarka dobiera wyniki. Indeks jest zbiorem informacji o stronach, a nie prostą kopią całej witryny; Google analizuje między innymi tekst, obrazy i dostępne zasoby.
Crawlowanie oznacza pobranie strony przez robota, indeksowanie oznacza analizę i zapis informacji o stronie, a wyświetlenie wyniku następuje przy zapytaniu użytkownika. Google opisuje te etapy oddzielnie i zaznacza, że nie każda strona przechodzi przez wszystkie; informacje sprawdziliśmy w październiku 2026 r. w dokumentacji etapów wyszukiwarki Google.
Strona może zostać pobrana bez dodania do indeksu, a zaindeksowana strona może nie pojawić się wysoko dla konkretnej frazy. Właściciel witryny powinien rozdzielić trzy pytania: czy Google zna URL, czy może go pobrać i czy zdecydował o jego indeksacji.
Jeśli Google nie zna adresu, sprawdź linkowanie wewnętrzne i sitemapę. Jeśli zna adres, ale go nie pobrał, sprawdź odpowiedź serwera i dostępność. Jeśli pobrał stronę, ale jej nie zaindeksował, sprawdź dyrektywy, canonical, podobne URL i przydatność treści.
Do kontroli stanu serwisu przydaje się zestaw narzędzi, a nie pojedynczy test. Darmowe narzędzia SEO i ich limity pomagają dobrać źródła danych do dalszej diagnozy. Jeśli problem dotyczy wielu adresów, pozycjonowanie SEO dla serwisu może objąć analizę techniczną i plan napraw.
Czytasz poradnik „Jak działa indeksowanie w wyszukiwarce Google? Etapy i diagnostyka”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak Google odkrywa adresy URL?
Google odkrywa adresy URL między innymi przez linki z już znanych stron i adresy umieszczone w sitemapie. Sitemap to plik zawierający adresy witryny, które właściciel chce udostępnić do crawlowania; przesłanie pliku jest wskazówką, a nie gwarancją odwiedzin ani indeksacji.
Link wewnętrzny łączy nowy adres ze strukturą serwisu, a link zewnętrzny może wskazać Google stronę z innej witryny. Sitemap pomaga przekazać listę adresów, szczególnie przy dużym serwisie, nowej witrynie albo migracji. Google opisuje sitemapę jako jeden ze sposobów odkrywania adresów i zaznacza, że jej przesłanie nie gwarantuje crawlowania; źródło sprawdziliśmy w październiku 2026 r. w dokumentacji tworzenia i przesyłania sitemap.
Tabela porównuje metody odkrywania URL i wskazuje ich ograniczenia.
| Źródło | Zastosowanie | Ograniczenie |
|---|---|---|
| Link wewnętrzny | Łączy nową stronę ze strukturą serwisu | Osierocona strona może być trudna do znalezienia |
| Link zewnętrzny | Wskazuje adres z innej witryny | Właściciel nie kontroluje publikacji ani czasu odwiedzin |
| Sitemap XML | Przekazuje listę ważnych adresów serwisu | Nie wymusza crawlowania ani indeksowania |
| Sprawdzanie adresu URL | Umożliwia zgłoszenie pojedynczego URL z zarządzanej usługi | Wymaga uprawnień i podlega limitom |
Sitemapę i linkowanie wewnętrzne stosuj równolegle. Przygotuj sitemapę z kanonicznymi adresami zwracającymi prawidłową odpowiedź i prześlij ją w raporcie Mapy witryn w Search Console.
Adresy w sitemapie powinny być zgodne z wersjami kanonicznymi, których używają linki wewnętrzne. Nie dodawaj adresów z parametrami filtrów, przekierowujących ani oznaczonych jako noindex, jeśli nie mają trafiać do indeksu. Rozbieżności między sitemapą a linkami wewnętrznymi utrudniają interpretację sygnałów dotyczących preferowanej wersji.
Przy dużej witrynie dziel mapę według typu treści lub sekcji, aby łatwiej znaleźć grupę adresów z błędami. W Search Console raport Mapy witryn pokazuje, czy Google odczytał przesłany plik oraz ewentualne problemy przetwarzania. Jeżeli plik wskazuje URL spoza właściwej wersji domeny albo adresy przekierowane, popraw źródłowy generator mapy, a nie tylko pojedynczy wpis.
Co Googlebot robi podczas crawlowania?
Googlebot pobiera stronę i potrzebne zasoby, a następnie może renderować jej zawartość z użyciem JavaScript. Googlebot to robot używany przez Google do pobierania stron, a renderowanie oznacza przetworzenie kodu tak, aby można było odczytać zawartość widoczną użytkownikowi.
Crawlowanie zależy od odpowiedzi serwera, dostępności zasobów i reguł robots.txt. Odpowiedź 5xx wskazuje na błąd serwera, a blokada plików CSS lub JavaScript potrzebnych do wyświetlenia treści może utrudnić jej odczyt. Google opisuje pobieranie i renderowanie jako element crawlowania; informacje sprawdziliśmy w październiku 2026 r. w dokumentacji Googlebota.
Sprawdź URL w przeglądarce bez logowania, zweryfikuj kod odpowiedzi, a potem przejrzyj reguły robots.txt i dostępność zasobów. W Search Console użyj testu opublikowanego adresu URL, aby zobaczyć, czy Google może go pobrać i jaką treść odczytuje.
Robots.txt zarządza dostępem robotów do pobierania URL, ale nie jest pewną metodą usunięcia adresu z wyników. Dyrektywa noindex działa dopiero wtedy, gdy Googlebot może pobrać stronę i odczytać tę dyrektywę. Jeśli robots.txt blokuje dostęp do URL, robot może nie zobaczyć osadzonego na stronie noindex.
Błąd pobierania zasobów odróżnij od błędu renderowania. Jeśli kod HTML zawiera główną treść, ale test wskazuje problem z plikiem JavaScript, sprawdź, czy skrypt nie jest zablokowany i czy serwer zwraca go poprawnie. Jeśli treść pojawia się dopiero po interakcji użytkownika, sprawdź, czy Google może ją wyrenderować bez kliknięcia lub logowania.
Sprawdź również zachowanie po stronie serwera w czasie wzmożonego ruchu. Częste błędy 5xx, długie odpowiedzi i przerwy w dostępności mogą ograniczać możliwość pobierania stron. Zestaw logi serwera z datami crawlowania z Search Console, ale nie uznawaj każdego braku aktywności robota za błąd: Google sam wybiera, które URL pobiera i jak często.
Jeżeli witryna korzysta z renderowania po stronie klienta, porównaj HTML zwracany bez JavaScript z wyrenderowaną stroną. Najważniejsza treść, tytuł i linki powinny być dostępne dla robota. Testuj także obrazy i pliki stylów, bo niedostępne zasoby mogą zmienić sposób, w jaki Google interpretuje układ i zawartość strony.
Jak Google decyduje o dodaniu strony do indeksu?
Google dodaje stronę do indeksu, jeśli po jej pobraniu i analizie uzna, że może ją przetworzyć i uwzględnić w wynikach. Na decyzję wpływają dostępność, treść, dyrektywy indeksowania oraz wybór wersji kanonicznej spośród podobnych adresów.
Canonical to adres wskazany jako preferowana wersja strony spośród duplikatów lub bardzo podobnych URL. Google może pogrupować podobne strony i wybrać własny adres kanoniczny, dlatego deklarację rel="canonical", przekierowania, sitemapę i linki wewnętrzne utrzymuj w zgodzie. Google opisuje wybór kanonicznego URL w dokumentacji dotyczącej duplikatów; źródło sprawdziliśmy w październiku 2026 r.
Przy kontroli sprawdź, czy strona nie zawiera meta robots noindex, zwraca prawidłową odpowiedź i wskazuje oczekiwany canonical. Porównaj adres z sitemapą i linkami wewnętrznymi. Następnie sprawdź, czy treść odpowiada na odrębne pytanie użytkownika i wnosi informacje inne niż podobne karty lub kategorie.
Parametry, sortowanie i filtry mogą tworzyć wiele URL z tą samą lub bardzo podobną treścią. Ustal, które kombinacje mają samodzielną wartość i powinny być indeksowane, a które prowadzą do tej samej oferty. Dla wybranych wersji ustaw spójne linkowanie i canonical, a niepotrzebne warianty ogranicz zgodnie z funkcją strony.
W narzędziu Sprawdzanie adresu URL porównaj deklarowaną przez właściciela wersję kanoniczną z wersją wybraną przez Google, jeśli te dane są dostępne. Rozbieżność wskazuje na potrzebę kontroli duplikatów, przekierowań i linków wewnętrznych, ale sama nie przesądza, który sygnał spowodował wybór.
Zadbaj o odpowiedź HTTP właściwą dla stanu strony. Aktywny adres powinien zwracać treść, która rzeczywiście odpowiada URL, a usunięty produkt lub artykuł nie powinien pokazywać pustego szablonu ze statusem sukcesu. W przypadku wycofanego adresu zdecyduj, czy istnieje sensowny odpowiednik do przekierowania, czy strona powinna zwracać informację o usunięciu.
Google analizuje treść i elementy strony, ale obecność słów kluczowych nie stanowi samodzielnej gwarancji indeksacji. Zadbaj, aby każda ważna strona miała odrębny cel, komplet informacji potrzebnych użytkownikowi i linki z innych istotnych miejsc w serwisie. Strony automatycznie powielające opisy, filtry lub krótkie warianty kategorii mogą nie wnosić wystarczającej wartości.
Ile trwa indeksowanie strony?
Google nie gwarantuje czasu indeksowania, a prośba o crawlowanie nie powoduje natychmiastowego dodania strony do wyników. Dokumentacja Google podaje, że crawlowanie może potrwać od kilku dni do kilku tygodni, a zgłoszenie nie gwarantuje indeksacji; informację sprawdziliśmy w październiku 2026 r. w instrukcji zgłaszania prośby o ponowne crawlowanie.
Na czas odkrycia wpływają linki prowadzące do adresu, obecność w sitemapie i możliwość dostępu Googlebota. Na dalsze przetwarzanie wpływają odpowiedzi serwera, dostępność zasobów, zmiany treści i decyzja Google dotycząca dodania strony do indeksu.
Nie wyciągaj wniosków na podstawie jednego dnia ani nie zgłaszaj wielokrotnie niezmienionego URL. Google wskazuje, że ponawianie prośby dla tego samego adresu nie przyspiesza crawlowania. Po naprawie sprawdź adres ponownie i obserwuj datę ostatniego crawlowania oraz status w Search Console.
Z naszych wdrożeń wynika, że poprawa linkowania i usunięcie niezamierzonej blokady daje bardziej użyteczny sygnał diagnostyczny niż ponawianie zgłoszenia bez zmiany strony. Zalecamy zapisywać datę zmiany i jej zakres, żeby później powiązać aktualizację z wynikiem raportu.
Nie porównuj bezpośrednio czasu indeksacji dwóch URL bez uwzględnienia ich stanu i roli w witrynie. Nowa kategoria bez linków wewnętrznych, zmieniony adres po migracji i aktualizacja artykułu z silnym linkowaniem mają inne warunki odkrycia. Najpierw potwierdź, że robot może pobrać stronę i że adres nie ma błędnej dyrektywy.
Właściciel witryny może uporządkować kolejkę własnych działań, ale nie ustala harmonogramu crawlowania Google. Priorytet nadaj adresom ważnym dla użytkownika i biznesu, a następnie kontroluj grupy podobnych URL. Adresy filtrów, sortowania lub nieaktualnych parametrów nie muszą otrzymać takiego samego priorytetu jak główne kategorie i produkty.
Jak sprawdzić, na którym etapie utknęła strona?
Status pojedynczej strony sprawdzisz w Google Search Console przez Sprawdzanie adresu URL, a stan większej grupy stron przez raport Indeksowanie stron. Search Console może pokazać, czy Google zna adres, kiedy go ostatnio crawlowano i jaki stan indeksowania przypisuje URL.
Raport Indeksowanie stron służy do obserwowania grup adresów, a Sprawdzanie adresu URL pomaga diagnozować konkretną stronę. Raport grupowy nie zastępuje inspekcji pojedynczego adresu; informacje o zakresie raportu sprawdziliśmy w październiku 2026 r. w Pomocy Search Console.
Tabela łączy typowe statusy z pierwszą kontrolą dla właściciela serwisu. Etykieta statusu opisuje zgłoszony stan, ale nie zawsze wskazuje pełną przyczynę.
| Status lub sygnał | Co oznacza | Następna kontrola |
|---|---|---|
| URL nieznany Google | Google nie ma informacji o adresie | Dodaj link wewnętrzny i sprawdź sitemapę |
| Odkryto, obecnie nie zindeksowano | Google zna URL, ale go nie pobrał | Sprawdź linkowanie i dostępność serwera |
| Zeskanowano, obecnie nie zindeksowano | Google pobrał stronę, ale jej nie dodał | Oceń treść, podobieństwo i canonical |
| Zablokowano przez robots.txt | Reguła ogranicza pobranie strony | Sprawdź, czy blokada jest zamierzona |
| Wykluczono przez noindex | Strona ma dyrektywę zakazującą indeksowania | Usuń noindex, jeśli strona ma być indeksowana |
| Duplikat z inną stroną kanoniczną | Google wskazuje podobny URL jako wersję główną | Porównaj canonical, przekierowania i linki |
Tabela wskazuje pierwszy krok diagnostyczny, nie werdykt o przyczynie problemu. Etykiety w Search Console mogą być aktualizowane, dlatego sprawdź szczegóły statusu i wynik testu opublikowanego adresu.
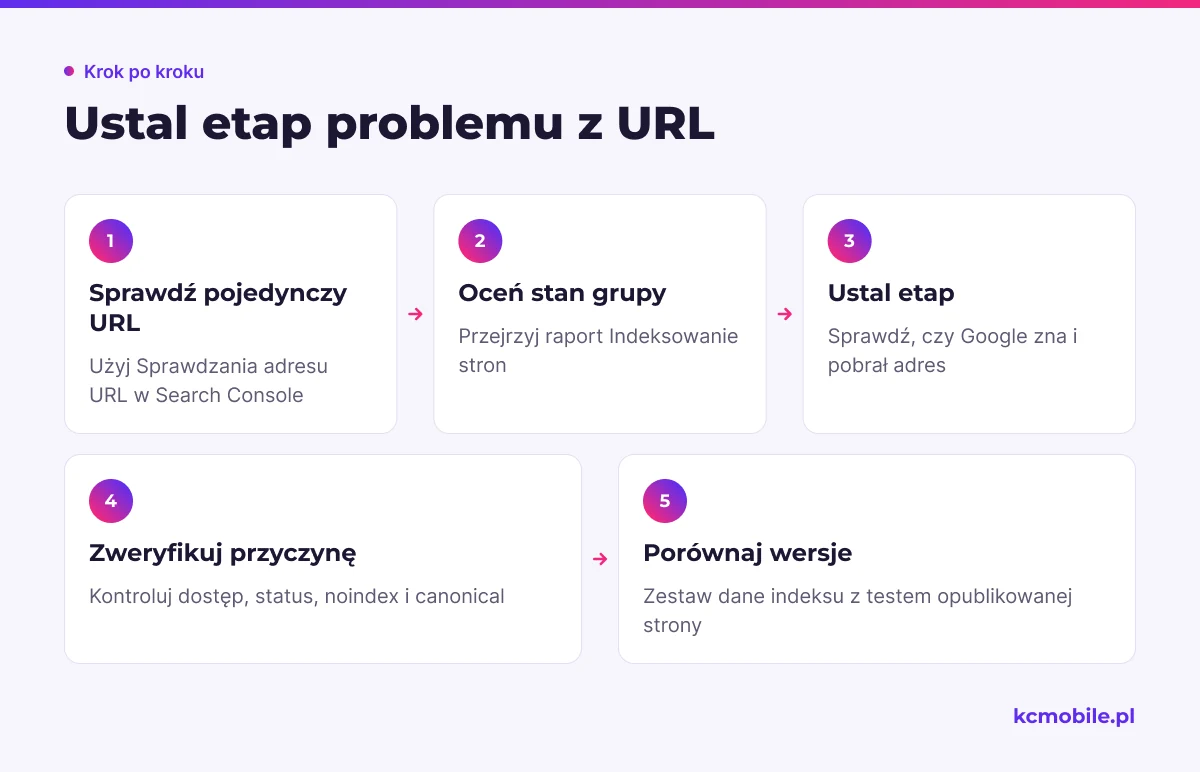
Tok diagnostyczny prowadź od odkrycia do decyzji o indeksacji. Jeśli Google nie zna URL, dodaj link wewnętrzny i sprawdź sitemapę. Jeśli zna, ale nie pobrał, zweryfikuj serwer, dostęp i robots.txt. Jeśli pobrał, ale nie zaindeksował, sprawdź noindex, canonical, podobne URL oraz zawartość strony.
Zapisuj dla każdego badanego URL status, datę ostatniego crawlowania, deklarowany canonical i wynik testu opublikowanej strony. Przy większej grupie adresów porównuj wzorce: wspólny szablon, katalog, filtr lub typ odpowiedzi serwera może wskazać przyczynę, której nie widać w pojedynczym URL.
W Sprawdzaniu adresu URL rozróżnij dane z indeksu od testu bieżącej wersji. Dane indeksu opisują ostatnie przetworzenie przez Google, a test opublikowanej strony sprawdza bieżącą dostępność i możliwość pobrania. Jeśli właśnie wdrożyłeś poprawkę, wynik testu może być prawidłowy, choć indeks nadal pokazuje wcześniejszy stan.
Raport grupowy może zawierać przykładowe URL, a nie kompletny eksport wszystkich stron danego typu. Wybierz kilka adresów z tej samej grupy oraz jeden działający odpowiednik, a potem porównaj ich szablon, odpowiedzi i dyrektywy. Taki zestaw ogranicza ryzyko naprawy jednego URL, gdy problem dotyczy reguły działającej na całym katalogu.
Dlaczego strona nie trafia do indeksu?
Strona może nie trafić do indeksu z powodu blokady technicznej, błędnego canonical, duplikacji albo treści, która nie wnosi wystarczającej wartości. Poprawne wyświetlenie w przeglądarce nie potwierdza, że Googlebot może pobrać i przetworzyć stronę.
Kontrolę prowadź w tej kolejności:
- Odpowiedź HTTP: sprawdź, czy URL zwraca kod 200, a nie błąd serwera, 404 lub przekierowanie do nieistniejącej strony.
- robots.txt: sprawdź, czy robot może pobrać URL oraz zasoby potrzebne do renderowania.
- noindex: sprawdź kod HTML i nagłówki odpowiedzi pod kątem dyrektywy noindex.
- canonical: porównaj wskazany adres z URL w sitemapie i linkach wewnętrznych.
- Duplikaty: sprawdź, czy parametry, filtry i podobne karty nie powielają treści.
- Treść: oceń, czy strona odpowiada na osobne pytanie i dostarcza użytkownikowi potrzebnych informacji.
Nie blokuj strony w robots.txt, jeśli chcesz, aby Google odczytał znajdującą się na niej dyrektywę noindex. Zablokowany adres może zostać znaleziony bez treści, a noindex działa wtedy, gdy robot może stronę pobrać. Google opisuje tę różnicę w dokumentacji dyrektyw robots; źródło sprawdziliśmy w październiku 2026 r.
Przy odpowiedzi 5xx sprawdź logi serwera i dostępność w okresie, w którym Googlebot próbował pobrać stronę. Przy odpowiedzi 404 potwierdź, czy URL ma być usunięty, czy błędny jest link kierujący do niego. Dla przekierowania sprawdź adres docelowy i upewnij się, że prowadzi do właściwej, działającej strony.
Przy statusie "Zeskanowano, obecnie nie zindeksowano" problem może dotyczyć decyzji o treści, a nie samego dostępu. Porównaj stronę z innymi adresami w serwisie: sprawdź, czy ma własny opis, użyteczne informacje i uzasadniony cel. Sama zmiana tytułu nie rozwiąże problemu, jeśli treść pozostaje kopią innej strony.
Sprawdź też, czy strona nie wymaga logowania, zgody na skrypt albo interakcji, której Googlebot nie wykonuje. Treść dostępna dopiero po działaniu użytkownika może nie być widoczna w teście renderowania. Porównaj kod źródłowy z wersją wyrenderowaną oraz sprawdź, czy ważne linki prowadzą do adresów dostępnych bez sesji.
Nie każda strona spoza indeksu wymaga naprawy. Duplikat, nieaktualny filtr, strona z noindex ustawionym celowo lub usunięty produkt bez odpowiednika mogą prawidłowo pozostać poza indeksem. Oceń status względem intencji strony i nie dąż do indeksowania wszystkich technicznych URL serwisu.
Jak zgłosić stronę do ponownego sprawdzenia?
Pojedynczy URL możesz zgłosić przez Sprawdzanie adresu URL w Search Console, a większą grupę adresów przez przesłanie sitemap XML. Zgłoszenie ma sens po publikacji nowej strony albo naprawieniu przyczyny, która blokowała crawlowanie lub indeksowanie.
Aby zgłosić jeden adres, wybierz właściwość witryny, wklej pełny URL w narzędziu inspekcji, sprawdź wynik dla opublikowanej strony i wybierz prośbę o indeksowanie, jeśli narzędzie ją udostępnia. Do zgłoszenia potrzebujesz uprawnień właściciela lub pełnego użytkownika usługi; Google stosuje limit próśb, a wielokrotne zgłaszanie tego samego adresu nie przyspiesza crawlowania. Zasady sprawdziliśmy w październiku 2026 r. w oficjalnej instrukcji Google.
Sitemapę prześlij w raporcie Mapy witryn w Search Console i upewnij się, że zawiera kanoniczne, dostępne adresy. Po wysłaniu sprawdź, czy raport rozpoznaje plik oraz czy nie zgłasza błędów odczytu lub nieprawidłowych URL.
Zgłoszenie pomaga Google odkryć adres lub ponownie go sprawdzić, ale nie naprawi błędnego canonical, noindex, blokady serwera ani treści, której Google nie zdecyduje się dodać do indeksu. Przed zgłoszeniem usuń przyczynę i użyj testu opublikowanej strony, aby zweryfikować stan po zmianie.
Po zgłoszeniu zapisz datę, adres i zmianę, której dotyczy prośba. Sprawdź raport ponownie po czasie, zamiast wielokrotnie wysyłać identyczną prośbę. Jeśli test opublikowanego URL nadal pokazuje blokadę, wróć do źródła błędu: reguły robots.txt, dyrektywy, odpowiedzi serwera albo dostępności zasobu.
Jeśli diagnoza obejmuje wiele URL, błędne canonicale lub szablony, pozycjonowanie SEO dla serwisu może objąć analizę techniczną, priorytety napraw i kontrolę efektów po wdrożeniu. Gdy problem dotyczy szerszej widoczności organicznej, obsługa pozycjonowania SEO pozwala zaplanować dalsze prace nad serwisem i monitoringiem.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Jaka jest różnica między crawlowaniem a indeksowaniem?
Czy można wymusić indeksowanie strony w Google?
Czy strona zablokowana w robots.txt może pojawić się w Google?
Czy zaindeksowana strona musi być widoczna wysoko w wynikach?
Co zrobić po zmianie treści strony?
Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Jak działa indeksowanie w wyszukiwarce Google? Etapy i diagnostyka”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.