Nie każda dyrektywa dla robota usuwa stronę z Google. Wybór zależy od tego, czy chcemy sterować pobieraniem adresów, wykluczyć publiczną treść z wyników wyszukiwania, czy ograniczyć dostęp do prywatnych danych.
Krótka odpowiedź
robots.txt przekazuje zgodnym robotom instrukcje crawlowania, czyli pobierania adresów. Meta robots w HTML i nagłówek HTTP X-Robots-Tag mówią, jak wyszukiwarka ma traktować pobraną stronę lub plik, na przykład nie indeksować go po odczytaniu noindex.
Żaden z tych mechanizmów nie zabezpiecza treści przed osobą, która zna adres; do prywatnych danych potrzebne jest uwierzytelnianie.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Robots.txt a meta tagi robots: czym się różnią i kiedy ich używać?”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czym różnią się robots.txt i meta robots?
robots.txt przekazuje zgodnym robotom instrukcje crawlowania ścieżek na danym hoście, ale nie blokuje technicznie dostępu do tych adresów. Plik znajduje się zwykle pod adresem `https://example.pl/robots.txt`, a reguły `User-agent`, `Disallow` i `Allow` opisują, które ścieżki robot powinien pobierać.
Meta robots przekazuje dyrektywy indeksowania w odpowiedzi HTML, najczęściej w sekcji `
`. Przykład: ``. Robot musi pobrać stronę, żeby odczytać tę regułę. Nagłówek HTTP `X-Robots-Tag` przekazuje dyrektywy w odpowiedzi serwera i może dotyczyć pliku PDF, obrazu lub HTML.Tabela pokazuje, gdzie znajduje się każda dyrektywa i co robot musi pobrać, aby ją odczytać.
| Mechanizm | Lokalizacja | Cel | Wymagany odczyt |
|---|---|---|---|
| robots.txt | `/robots.txt` na hoście | Instrukcja crawlowania ścieżek | Reguła przed pobraniem adresu |
| Meta robots | Kod HTML strony | Indeksowanie i prezentacja strony | Odpowiedź HTML |
| X-Robots-Tag | Nagłówek odpowiedzi HTTP | Indeksowanie strony lub pliku | Nagłówek odpowiedzi |
Różnica praktyczna polega na momencie odczytu: robots.txt steruje crawlowaniem, a meta robots i X-Robots-Tag wymagają pobrania odpowiedzi. Google wymaga, aby robot mógł pobrać stronę lub plik, jeśli ma zastosować dyrektywę indeksowania.
Czytasz poradnik „Robots.txt a meta tagi robots: czym się różnią i kiedy ich używać?”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Który mechanizm wybrać w typowej sytuacji?
Do wykluczenia publicznej strony z wyników Google wybierz `noindex`, a do ochrony prywatnej treści zastosuj kontrolę dostępu na serwerze. robots.txt wykorzystuj do przekazywania instrukcji crawlowania, gdy robot nie musi pobierać danej ścieżki.
Tabela odpowiada, jakie działanie dobrać do celu i typu zasobu.
| Sytuacja | Działanie | Powód |
|---|---|---|
| Strona ma być indeksowana | Usuń `noindex` i pozwól robotowi pobrać stronę | Google musi poznać jej treść |
| Publiczna strona ma zniknąć z wyników | Pozwól na crawlowanie i ustaw `noindex` | Wyszukiwarka musi odczytać dyrektywę |
| Ścieżka techniczna nie wymaga crawlowania | Rozważ precyzyjną regułę robots.txt | Robot otrzymuje instrukcję pobierania |
| CSS lub JavaScript służy do renderowania strony | Nie blokuj potrzebnych zasobów | Google może nie zobaczyć poprawnie strony |
| Treść jest prywatna | Wymagaj logowania lub autoryzacji | Dyrektywy robots nie chronią dostępu |
Sama reguła robots.txt nie kontroluje, kto może otworzyć adres. Gdy strona zawiera dane dostępne wyłącznie dla uprawnionych osób, serwer powinien wymagać uwierzytelnienia.
Jak wykluczyć stronę z indeksu?
Publiczną stronę HTML wykluczysz z indeksu, dodając `noindex` w meta robots lub w nagłówku HTTP `X-Robots-Tag`. W kodzie HTML umieść na przykład ``; nagłówek HTTP wybierz, gdy ta sama reguła ma obejmować także pliki inne niż HTML.
Po wdrożeniu sprawdź dokładny adres i końcową odpowiedź serwera. W Google Search Console otwórz Inspekcję adresu URL i uruchom test opublikowanego adresu. Potwierdź, że robot może pobrać stronę i odczytać właściwą dyrektywę.
Raport indeksowania stron opisuje informacje znane Google z poprzedniego przetworzenia, a test na żywo pokazuje bieżącą odpowiedź. Jeśli poprawiasz błędne dyrektywy w szerszym zakresie, pozycjonowanie SEO może objąć diagnostykę indeksowania oraz plan napraw technicznych.
Dlaczego blokada crawlowania w robots.txt nie usuwa adresu z Google?
Adres zablokowany dla crawlowania może pozostać znany Google, jeśli wyszukiwarka odkryła go w linku lub innym źródle. Google może wtedy nie pobrać treści, więc nie odczyta meta robots ani nagłówka z odpowiedzi.
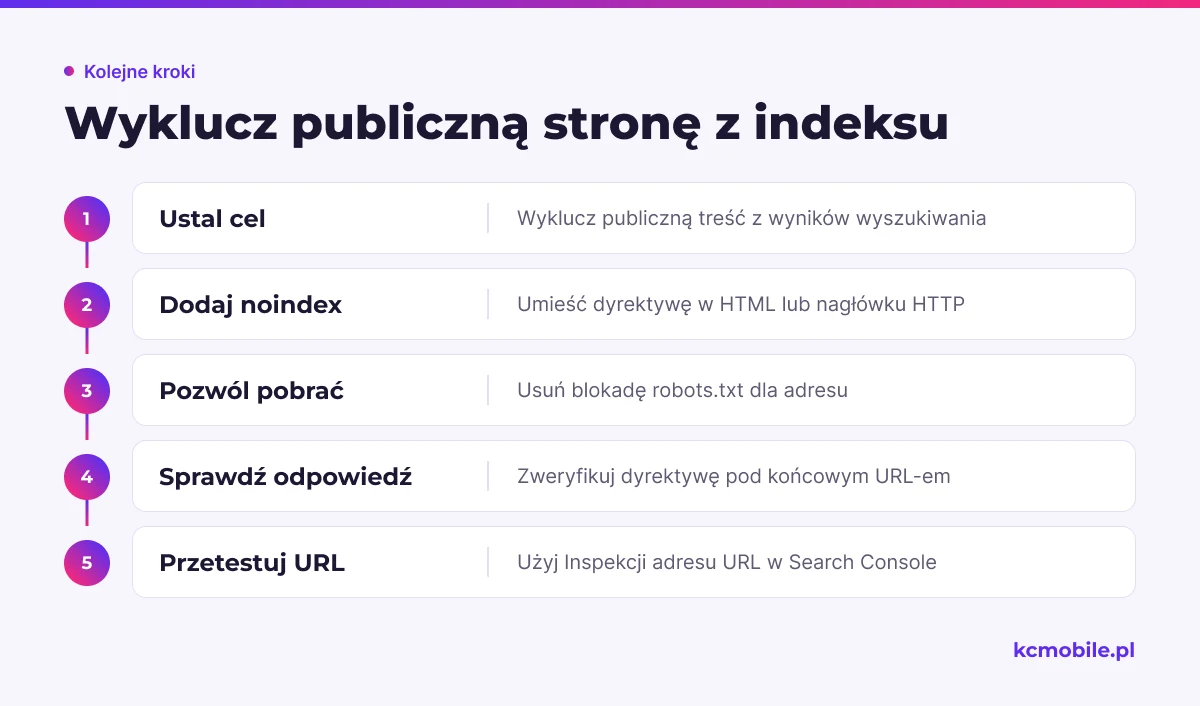
Jeśli adres ma zniknąć z wyników, usuń lub zawęź pasującą regułę crawlowania, a następnie pozwól Google pobrać URL z dyrektywą `noindex`. Sprawdź efekt w Inspekcji adresu URL, a po ponownym przetworzeniu skontroluj status indeksowania. Gdy treść została trwale usunięta, zwróć odpowiedź `404` lub `410` zamiast pozostawiać pustą stronę.
Narzędzie Usunięcia w Search Console służy do tymczasowego ukrycia wyniku i nie zastępuje trwałej dyrektywy ani ochrony dostępu. Google wskazuje, że aby wykluczyć stronę z indeksu, należy usunąć blokadę robots.txt i użyć `noindex`.
Jak obsłużyć pliki PDF i inne zasoby?
Plik PDF można wykluczyć z indeksu przez nagłówek HTTP `X-Robots-Tag: noindex`, ponieważ PDF nie ma kodu HTML z meta tagiem. Google obsługuje X-Robots-Tag także dla obrazów i innych typów zasobów.
Przykładowa odpowiedź serwera zawiera status, typ pliku i dyrektywę:
HTTP/1.1 200 OK
Content-Type: application/pdf
X-Robots-Tag: noindex
Na serwerze Apache regułę można skonfigurować w `.htaccess` lub konfiguracji serwera. W NGINX dyrektywę można dodać w odpowiednim bloku `location`. Właściwe miejsce zależy od tego, czy plik obsługuje serwer, aplikacja czy CDN.
Po wdrożeniu sprawdź końcową odpowiedź, w tym status, `Content-Type`, przekierowania i nagłówek `X-Robots-Tag`. Jeśli CDN buforuje pliki, odświeżenie pamięci podręcznej może być potrzebne, aby nowy nagłówek pojawił się w odpowiedzi. robots.txt musi pozwolić Google pobrać plik, żeby robot mógł zobaczyć nagłówek.
Jak sprawdzić wdrożone dyrektywy?
Sprawdź osobno instrukcje crawlowania, treść odpowiedzi i stan indeksowania raportowany przez Google. Test w przeglądarce pokazuje odpowiedź dla użytkownika, ale sam nie potwierdza, jak Google przetworzył adres.
Tabela wskazuje, gdzie sprawdzić każdą warstwę i jaki wynik potwierdzić.
| Test | Narzędzie lub miejsce | Co potwierdzić |
|---|---|---|
| robots.txt | `/robots.txt` i raport robots.txt w Search Console | Dostępność pliku i regułę dla ścieżki |
| Meta robots | Źródło HTML lub narzędzia deweloperskie | Dyrektywę w odpowiedzi strony |
| X-Robots-Tag | Nagłówki końcowej odpowiedzi HTTP | Nagłówek po przekierowaniach i statusie |
| Dostęp robota | Inspekcja adresu URL w Search Console | Możliwość pobrania i wynik testu |
| Stan indeksu | Raport indeksowania stron w Search Console | Powód aktualnego statusu adresu |
Test na żywo dotyczy bieżącej odpowiedzi, a raport indeksowania pokazuje stan po wcześniejszym przetworzeniu przez Google. Sprawdź oba wyniki po zmianie.
Jakie błędy powodują problemy z indeksacją?
Błąd `noindex` na stronie równocześnie objętej `Disallow` uniemożliwia robotowi odczytanie dyrektywy z odpowiedzi. Problemy powodują też reguły obejmujące niezamierzone ścieżki oraz sprawdzanie innego wariantu URL niż ten, który ma indeksować Google.
Przed zmianą porównaj zakres reguł z opublikowaną odpowiedzią. Sprawdź w szczególności:
- `Disallow: /` przeniesione ze środowiska testowego na produkcję.
- Blokadę CSS lub JavaScript wymaganego do wyrenderowania strony.
- `noindex` dodane jednocześnie przez wtyczkę SEO i szablon.
- Różnice między `http` i `https`, wersją `www` i bez `www` oraz adresem przed i po przekierowaniu.
- Nagłówek `X-Robots-Tag` obejmujący cały katalog zamiast wyłącznie plików PDF.
Przy sprzecznych regułach indeksowania Google stosuje bardziej restrykcyjną dyrektywę. Z naszych wdrożeń wynika, że sprawdzenie odpowiedzi pod docelowym URL-em pomaga znaleźć rozbieżności między ustawieniem w CMS a regułą wysyłaną przez serwer.
Jak sprawdzić zmianę przed publikacją?
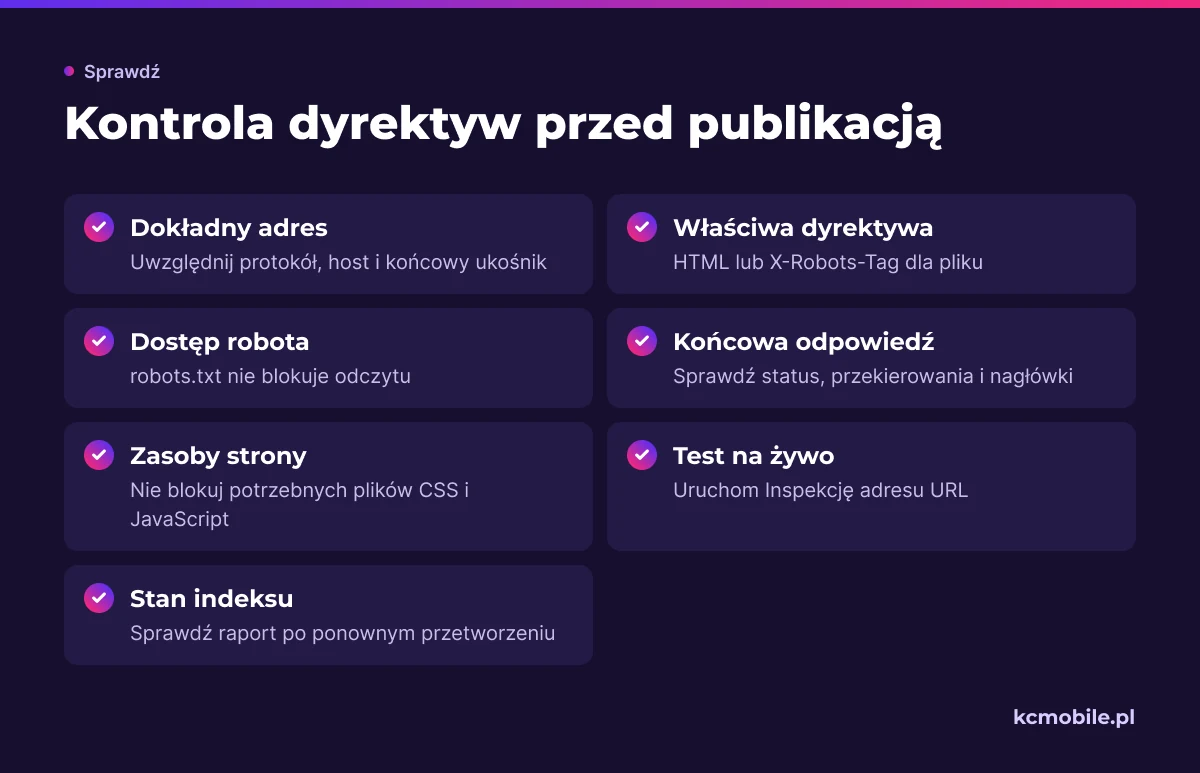
Przed publikacją ustal, czy celem jest zmiana crawlowania, indeksowania czy dostępu do prywatnej treści. Następnie sprawdź odpowiedź dla docelowego URL-a i porównaj ją ze stanem po ponownym przetworzeniu przez Google.
- Zapisz dokładny URL wraz z protokołem, hostem i końcowym ukośnikiem.
- Wybierz `noindex` w HTML dla strony albo X-Robots-Tag dla odpowiedzi HTTP i plików.
- Sprawdź, czy robots.txt nie uniemożliwia robotowi pobrania dyrektywy.
- Zweryfikuj status, przekierowania, kod HTML i nagłówki końcowej odpowiedzi.
- Skontroluj, czy reguła nie obejmuje potrzebnych plików CSS, JavaScript ani innych zasobów.
- Uruchom test opublikowanego adresu w Inspekcji adresu URL.
- Po ponownym przetworzeniu sprawdź stan URL-a w indeksie.
Zmiany w robots.txt mogą dotyczyć wielu adresów pasujących do tej samej ścieżki, dlatego sprawdź także przykładowe strony, które mają pozostać dostępne. Gdy potrzebujesz wykonawcy, obsługa pozycjonowania strony w Google może objąć kontrolę dyrektyw oraz dalszy rozwój widoczności organicznej.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Czy robots.txt może zabezpieczyć prywatną stronę przed wejściem?
Czy mogę jednocześnie ustawić Disallow i noindex?
Czy X-Robots-Tag działa dla plików PDF?
Czy usunięcie adresu w Search Console jest trwałe?
Jak sprawdzić, czy Google odczytał noindex?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Robots.txt a meta tagi robots: czym się różnią i kiedy ich używać?”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.