Eksport z crawla nie poprawia linkowania, jeśli nie wiadomo, które adresy są ważne i gdzie leży źródło problemu. Pokażemy, jak przygotować Screaming Frog, sprawdzić połączenia między stronami i zamienić wyniki w listę zmian do wdrożenia.
Krótka odpowiedź
W Screaming Frog uruchom crawl domeny w trybie Spider, a po jego zakończeniu sprawdź raporty Inlinks, Outlinks, Crawl Depth i Response Codes. Porównaj wyniki z sitemap XML oraz Google Search Console, ponieważ crawler może nie odkryć adresu, do którego nie prowadzi dostępny link.
Potwierdź każdy sygnał na stronie źródłowej, a następnie zapisz konkretną zmianę w menu, treści, szablonie albo przekierowaniu.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Jak analizować linkowanie wewnętrzne w Screaming Frog krok po kroku”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Co sprawdzić przed crawlem strony?
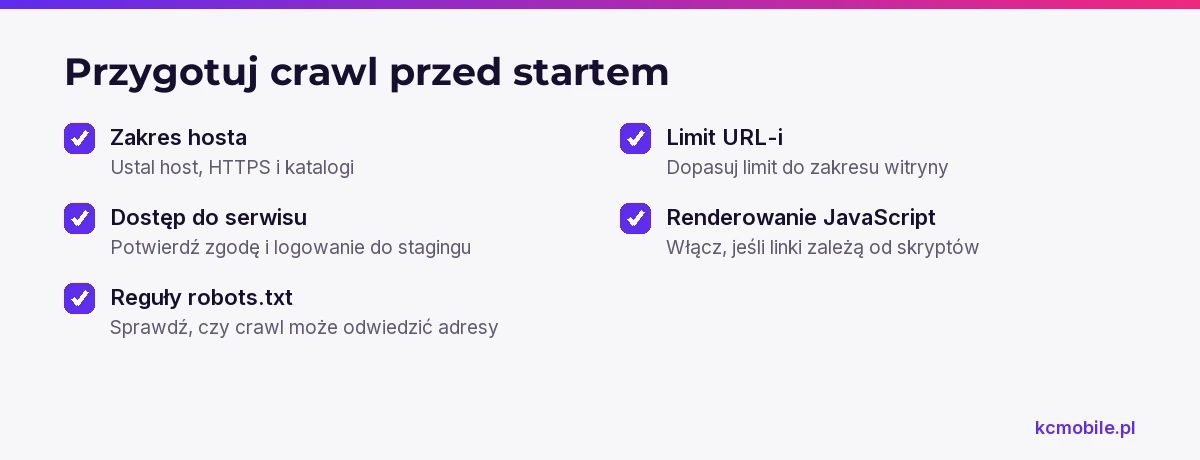
Przed crawlem ustal zakres hosta, dostęp do serwisu i limity, aby wynik obejmował właściwe adresy bez niepotrzebnego obciążenia serwera. Crawl to automatyczne przechodzenie robota po linkach wykrytych od wskazanego adresu startowego.
Sprawdź, czy masz zgodę na crawl środowiska produkcyjnego lub stagingu. Dla stagingu potwierdź dane logowania i reguły `robots.txt`; autoryzację formularzem skonfigurujesz w `Configuration > Authentication > Forms Based`. Screaming Frog respektuje reguły `robots.txt`, dlatego nie włączaj ich ignorowania bez uzgodnienia z administratorem.
Ustal, czy analizujesz host `www` czy bez `www`, HTTPS, poddomeny i katalogi. Jeśli startujesz z podkatalogu, a potrzebujesz całej witryny, sprawdź `Configuration > Spider > Crawl > Crawl Outside of Start Folder`. Limit liczby adresów znajdziesz w `Configuration > Spider > Limits > Limit Crawl Total`. Według dokumentacji Screaming Frog bezpłatna wersja ma limit 500 URL-i, a licencjonowana ma domyślny limit 5 milionów, który można zmienić. Informacje sprawdziliśmy w październiku 2026 roku.
Renderowanie JavaScript włącz, jeśli ważne linki pojawiają się dopiero po wykonaniu skryptów. Ustawienie znajduje się w `Configuration > Spider > Rendering`; renderowanie pobiera zasoby i przetwarza stronę w przeglądarce, dlatego crawl może trwać dłużej i zużywać więcej zasobów.
Przed startem sprawdź:
- Czy zakres hosta i katalogów odpowiada celowi audytu.
- Czy staging wymaga logowania i czy dostęp został skonfigurowany.
- Czy limit URL-i pasuje do wielkości serwisu i możliwości komputera.
- Czy analiza wymaga renderowania JavaScript.
Crawl produkcyjny może wysyłać wiele żądań do serwera. Przy dużych witrynach ustal z administratorem bezpieczne tempo i obserwuj czasy odpowiedzi serwera. Jeśli chcesz przełożyć analizę widoczności na plan prac, pozycjonowanie SEO dla firmy obejmuje diagnozę i dalsze działania.
Czytasz poradnik „Jak analizować linkowanie wewnętrzne w Screaming Frog krok po kroku”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak uruchomić crawl pod kątem linków wewnętrznych?
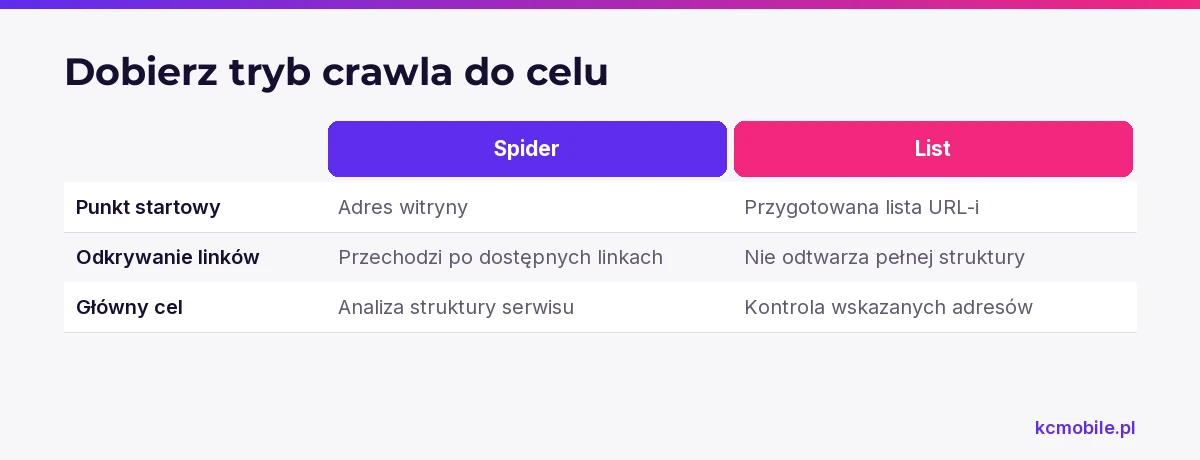
Crawl linków wewnętrznych uruchom w trybie Spider od kanonicznego adresu strony głównej, jeśli chcesz odtworzyć strukturę dostępną przez linki. Wpisz adres startowy, wybierz `Mode > Spider` i naciśnij `Start`.
Po zakończeniu uruchom `Crawl Analysis`, gdy potrzebujesz filtrów wyliczanych na podstawie analizy linków, takich jak strony o dużej głębokości. Zapisz ustawienia przez `File > Configuration > Save As`, aby kolejny crawl można było powtórzyć przy tej samej konfiguracji. Tryb `List` sprawdza przygotowaną listę adresów, ale sam nie odtwarza ścieżki odkrywania linków od strony głównej.
Wybierz tryb według pytania, na które ma odpowiedzieć crawl. Tabela rozróżnia sprawdzenie struktury witryny od kontroli wskazanych adresów.
| Wariant | Kiedy go wybrać | Cel kontroli | Ograniczenie |
|---|---|---|---|
| Spider dla małego serwisu | Witryna mieści się w ustalonym limicie | Struktura linków | Odkrywa adresy przez dostępne linki |
| Spider dla sklepu | Trzeba przejść kategorie i produkty | Paginacja kategorii | Warianty URL mogą rozszerzyć crawl |
| Spider z JavaScript | Linki zależą od renderowania | Linki po renderze | Wymaga więcej czasu i zasobów |
| List | Analizujesz przygotowaną listę URL-i | Kody odpowiedzi adresów | Nie odkrywa pełnej struktury serwisu |
Wybierz Spider do analizy architektury, a List do kontroli wskazanych adresów, na przykład URL-i wyeksportowanych z innego źródła.
Jak znaleźć strony bez linków przychodzących?
Zero inlinks oznacza, że Screaming Frog nie wykrył linku przychodzącego w danym przebiegu crawla. Inlinks to odnośniki prowadzące do wybranego URL-a, które crawler znalazł na innych objętych analizą stronach.
W zakładce `Internal` wybierz adres, a następnie sprawdź dolny panel `Inlinks`. Eksport `Bulk Export > Links > All Inlinks` zapisuje relacje między URL-em źródłowym i docelowym, które można analizować w arkuszu. Adres z zerową liczbą inlinks traktuj jako kandydata do sprawdzenia, a nie automatycznie potwierdzoną stronę osieroconą.
Strona osierocona nie ma linków prowadzących do niej z analizowanej struktury witryny. Crawl może ją pominąć, jeśli adres nie występuje w wykrytych linkach, został zablokowany, wymaga logowania albo pojawia się dopiero po wykonaniu JavaScript. Porównaj więc wyniki z adresami z sitemap XML i Google Search Console.
Screaming Frog może pobrać adresy z sitemap XML po włączeniu `Configuration > Spider > Crawl > Crawl Linked XML Sitemaps`. Możesz użyć sitemap wykrytej w `robots.txt` albo wskazać ją ręcznie. Integrację Search Console skonfigurujesz w `Configuration > API Access > Google Search Console`; narzędzie może pobierać dane Search Analytics, a opcjonalna funkcja URL Inspection sprawdza do 2 000 adresów na usługę Search Console dziennie. Ścieżki i limit sprawdziliśmy w październiku 2026 roku w dokumentacji Screaming Frog.
Porównanie źródeł pozwala wyodrębnić adresy zewnętrzne wobec crawla, adresy brakujące w sitemapie oraz URL-e ze statusem lub kanonicznym adresem wymagającym kontroli. Nie każdy adres bez inlinks należy podlinkować. Najpierw potwierdź, że URL jest kanoniczny, powinien być indeksowany i odpowiada na potrzebę użytkownika.
Szczegółowy dobór narzędzi opisuje poradnik analizy struktury strony.
Jak ocenić liczbę i jakość linków do ważnych URL-i?
Liczbę linków do ważnego URL-a oceniaj razem ze źródłem, anchorem i miejscem występowania. Sama wartość inlinks nie rozstrzyga, czy strona jest dobrze osadzona w architekturze.
Wybierz URL w `Internal`, a następnie przejrzyj `Inlinks`: adres źródłowy, tekst anchora, typ linku i lokalizację. Porównuj strony o podobnej roli, na przykład kategorię z kategorią, a nie kategorię z wpisem blogowym. Sprawdź linki z menu i nawigacji, ponieważ powtarzające się odnośniki szablonowe mogą podwyższać łączną liczbę linków.
Tabela wiąże sygnał z raportu z kontrolą i miejscem możliwej zmiany. Działanie zapisz dopiero po sprawdzeniu wskazanych adresów źródłowych.
| Sygnał | Co sprawdzić | Możliwa zmiana | Miejsce wdrożenia |
|---|---|---|---|
| Ważna strona ma mało inlinks | Linki z powiązanych stron | Dodać odnośnik kontekstowy | Treść |
| Anchor nie opisuje celu | Zgodność tekstu z URL-em docelowym | Zmienić anchor na opisowy | Nawigacja |
| Link występuje tylko w stopce | Dostępność linku w kontekście | Dodać odnośnik tematyczny | Treść |
| Link prowadzi przez przekierowanie | Istnienie aktualnego URL-a | Podmienić stary adres | Szablon |
Jeśli ważna kategoria ma linki wyłącznie ze stopki, otwórz wskazane strony źródłowe i sprawdź, czy istnieje tematycznie powiązany tekst, z którego użytkownik naturalnie może do niej przejść.
Jak wykryć błędne linki wewnętrzne i przekierowania?
Link wewnętrzny do odpowiedzi 4xx, 5xx lub przekierowania warto poprawić u źródła, jeśli istnieje prawidłowy adres docelowy. Kody 4xx oznaczają błędy żądania, a 5xx wskazują problem po stronie serwera.
Otwórz `Response Codes` i wybierz filtry `Client Error (4xx)`, `Server Error (5xx)` oraz `Redirection (3xx)`. Dla znalezionego URL-a sprawdź panel `Inlinks`, aby ustalić, które strony zawierają odnośnik. Odróżnij nieaktualny link od celowego przekierowania, na przykład wdrożonego podczas migracji.
Ustal właściwy URL docelowy, a następnie popraw źródło linku w menu, treści, stopce lub szablonie. Nowy adres powinien zachować intencję starego URL-a. Po wdrożeniu uruchom crawl ponownie i sprawdź, czy źródła prowadzą bezpośrednio do działającej strony.
Jeśli ten sam błąd pojawia się w wielu szablonach, sprawdź wspólny komponent przed ręczną edycją pojedynczych stron. Korekta menu może usunąć kilka błędnych linków, ale najpierw potwierdź, że wskazują na ten sam nieaktualny adres.
Jak znaleźć strony ważne, ale głęboko ukryte?
Crawl Depth pokazuje liczbę kliknięć od adresu startowego do URL-a w strukturze odtworzonej przez crawler. W zakładce `Internal` posortuj kolumnę `Crawl Depth`; filtr `Pages with high crawl depth` w zakładce `Links` wymaga wykonania `Crawl Analysis`.
Nie stosuj jednej wartości jako uniwersalnego progu. Porównaj głębokość z rolą URL-a: ważny produkt lub kategoria może wymagać krótszej ścieżki niż archiwalny wpis. Crawl Depth opisuje drogę znalezioną przez crawler od wybranego adresu startowego, a nie każdą możliwą drogę użytkownika.
Tabela wskazuje, co sprawdzić dla typów stron o różnych rolach. Wybierz zmianę zgodną z ich miejscem w strukturze, a nie z samą liczbą kliknięć.
| Typ strony | Sygnał do sprawdzenia | Działanie do rozważenia |
|---|---|---|
| Kategoria | Głębsza ścieżka niż dla równorzędnych kategorii | Dodać link ze strony nadrzędnej |
| Produkt | Mało ścieżek wejścia do produktu | Dodać link z kategorii |
| Usługa | Brak linków z głównych sekcji | Uzupełnić nawigację |
| Wpis | Trudno dotrzeć do treści wspierającej usługę | Połączyć z właściwą stroną tematyczną |
Zmiana powinna wynikać z roli URL-a i jego relacji tematycznych.
Jak połączyć crawl z Google Search Console?
Google Search Console uzupełnia crawl o dane o wyświetleniach, kliknięciach i indeksowaniu, których Screaming Frog nie wywnioskuje z samych linków. Brak inlinks nie dowodzi braku indeksacji, a obecność URL-a w crawlu nie potwierdza, że Google go indeksuje.
Integrację skonfigurujesz w Screaming Frog przez `Configuration > API Access > Google Search Console`. Połącz konto Google z dostępem do właściwości i wybierz dane do pobrania. Screaming Frog może pobierać kliknięcia, wyświetlenia, CTR i pozycję z Search Analytics; URL Inspection zwraca status indeksowania dla maksymalnie 2 000 adresów na usługę Search Console dziennie. Limit sprawdziliśmy w październiku 2026 roku w dokumentacji producenta.
Porównaj adresy z małą liczbą linków z raportem skuteczności Search Console. Strona z wyświetleniami lub kliknięciami, ale słabo osadzona w linkowaniu, może zasługiwać na wzmocnienie. URL z zerowymi danymi wymaga sprawdzenia zakresu dat, filtra strony, kanonicznego adresu i stanu indeksowania.
Zakres innych rozwiązań zebraliśmy w rankingu darmowych narzędzi SEO.
Jak zamienić eksport w plan naprawczy?
Plan naprawczy powinien wskazywać potwierdzony problem, miejsce zmiany, właściciela zadania, priorytet i status. Taki zapis oddziela sygnał z crawla od usterki zweryfikowanej na stronie.
Eksportuj relacje przez `Bulk Export > Links > All Inlinks`, a błędne odpowiedzi przez odpowiedni filtr `Response Codes`. Połącz rekordy według URL-a docelowego i przypisz właściciela: redakcję, programistę albo osobę odpowiedzialną za nawigację.
Tabela pokazuje minimalny zestaw pól do przekazania zadań zespołowi. Każdy rekord powinien wskazywać źródło, cel i osobę odpowiedzialną za wdrożenie.
| Pole | Co zapisać | Przykład |
|---|---|---|
| URL źródłowy | Stronę zawierającą link | `/kategorie/akcesoria/` |
| URL docelowy | Adres, do którego prowadzi link | `/produkt/wybrany-model/` |
| Problem | Usterkę potwierdzoną na stronie | Link prowadzi przez przekierowanie |
| Właściciel | Osobę lub zespół wdrażający | Programista |
| Status | Aktualny etap zadania | Do wdrożenia |
Najpierw popraw linki do błędnych i przekierowanych adresów, potem uzupełnij połączenia ważnych URL-i. Po publikacji uruchom crawl z zapisaną konfiguracją i zamknij pozycje, które zniknęły albo zostały świadomie zaakceptowane.
Perspektywa KC Mobile. Plan jest gotowy do wdrożenia, gdy zespół potrafi wskazać konkretną stronę źródłową, docelową i miejsce zmiany. Jeśli potrzebujesz wykonawcy, pozycjonowanie SEO i plan poprawy widoczności mogą objąć analizę oraz kontrolę wdrożonych zmian.
Dalszą diagnostykę adresów opisują sprawdzanie URL-a strony oraz analiza SEO strony krok po kroku. Dla porównania profilu linków zewnętrznych przydatny może być poradnik jak sprawdzić Ahrefs swojej strony.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Jak sprawdzić linkowanie wewnętrzne w Screaming Frog?
Jak znaleźć strony osierocone w Screaming Frog?
Co oznacza liczba inlinks w Screaming Frog?
Jak sprawdzić głębokość strony w strukturze serwisu?
Czy Screaming Frog wykryje linki dodawane przez JavaScript?
Jak wyeksportować linki wewnętrzne do arkusza?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Jak analizować linkowanie wewnętrzne w Screaming Frog krok po kroku”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.