Uruchomienie kolejnych wersji językowych zwiększa liczbę adresów, które Google może odkryć, ale samo w sobie nie potwierdza problemu z crawlowaniem. Zanim ograniczymy języki lub zablokujemy adresy, sprawdzamy, które URL-e odwiedza Googlebot, jak odpowiada serwer i co pokazują raporty Google Search Console.
Krótka odpowiedź
Crawl budget to zestaw adresów URL, które Google może i chce crawlowć. Łączy limit crawlowania wynikający między innymi z wydolności serwera z zapotrzebowaniem Google na odwiedzanie znanych adresów.
Dodatkowy język zwiększa pulę możliwych URL-i, ale optymalizacja ma sens dopiero wtedy, gdy dane pokazują marnowanie crawlowania lub pomijanie ważnych stron.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Wersje językowe i ich wpływ na crawl budget w SEO”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czym jest crawl budget i kiedy ma znaczenie?
Crawl budget to zestaw adresów URL, które Google może i chce crawlowć, a jego wielkość wynika z limitu crawlowania i zapotrzebowania na odwiedzanie stron. Dokumentacja Google opisuje limit jako zdolność serwera do obsługi żądań Google, a zapotrzebowanie jako ocenę, które adresy warto pobierać i odświeżać.
Limit i zapotrzebowanie opisują różne kwestie. Limit crawlowania zależy między innymi od kondycji hosta: wolne odpowiedzi, błędy 5xx i ograniczanie żądań 429 mogą zmniejszyć liczbę pobrań. Zapotrzebowanie zależy między innymi od rozmiaru serwisu, częstotliwości aktualizacji, jakości i popularności stron. Dobry serwer sam nie sprawi, że Google częściej pobierze mało przydatne lub nieodkryte treści.
Google kieruje zaawansowany przewodnik głównie do bardzo dużych lub często aktualizowanych serwisów. Wymienia orientacyjnie witryny z co najmniej 1 milionem unikalnych stron aktualizowanych umiarkowanie często, witryny z co najmniej 10 000 unikalnych stron zmienianych codziennie oraz serwisy, w których duża część adresów ma status "Odkryto - obecnie nie zindeksowano" w Search Console. Google zaznacza, że liczby te są szacunkowe, a nie dokładnymi progami.
Dla serwisów mających mniej niż 1000 stron Google zaleca, że zwykle nie trzeba korzystać z raportu Statystyki indeksowania ani analizować crawlowania na tym poziomie szczegółowości. Centrum pomocy Search Console wskazuje też, że raport jest przeznaczony dla zaawansowanych użytkowników i dostępny dla właściwości na poziomie domeny lub głównego adresu URL.
Crawlowanie oznacza pobranie strony przez robota, a indeksowanie oznacza jej ocenę i ewentualne dodanie do indeksu. Google może pobrać stronę, a następnie jej nie zaindeksować, jeśli uzna treść za mało przydatną lub powielającą inne strony.
Jeśli wybierasz CMS dla serwisu obsługującego wiele języków, porównanie systemów CMS pomoże ocenić sposób zarządzania treścią i strukturą adresów. Przy wdrożeniu lub przebudowie witryny strony na WordPressie pozwalają zaplanować strukturę języków oraz publikację treści.
Czytasz poradnik „Wersje językowe i ich wpływ na crawl budget w SEO”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak wersje językowe zwiększają liczbę adresów URL?
Każda osobna wersja językowa może utworzyć dodatkowy adres URL, a filtry, sortowanie, paginacja i parametry mogą pomnożyć liczbę wariantów. Google zaleca osobne adresy dla wersji językowych, ponieważ treść zmieniana wyłącznie przez ustawienie przeglądarki lub ciasteczko może utrudnić robotowi odkrycie wszystkich wariantów.
Model poniżej pokazuje, jak rośnie liczba możliwych adresów przy określonej liczbie stron, języków i wariantów. To proste mnożenie, a nie próg Google ani prognoza liczby pobrań robota.
| Wariant serwisu | Strony bazowe (URL) | Języki (szt.) | Warianty URL na stronę (szt.) | Potencjalne adresy (URL) |
|---|---|---|---|---|
| Jedna wersja językowa | 1000 | 1 | 1 | 1000 |
| Trzy wersje językowe | 1000 | 3 | 1 | 3000 |
| Trzy wersje z filtrami | 1000 | 3 | 4 | 12000 |
| Trzy wersje z filtrami i sortowaniem | 1000 | 3 | 8 | 24000 |
Model pokazuje, że niekontrolowane filtry mogą zwiększyć pulę adresów szybciej niż dodawanie kolejnych języków.
Rzeczywista liczba URL-i zależy od tego, czy serwis generuje te adresy, prowadzą do nich linki i czy każdy wariant zwraca odrębną treść. Samo istnienie parametrów nie oznacza, że Googlebot je odkryje, ale linkowanie do wszystkich kombinacji może tworzyć niemal nieograniczoną przestrzeń adresów.
Przed publikacją nowego języka sprawdź kompletność oferty, jakość tłumaczeń i działanie odnośników między wariantami. Puste podstrony i automatyczne kopie powiększają zbiór adresów bez dostarczania użytecznej wersji użytkownikom.
Jak odróżnić problem crawl budgetu od problemu indeksacji?
Problem crawlowania podejrzewamy, gdy logi pokazują liczne pobrania niepotrzebnych adresów, a ważne URL-e są rzadko odwiedzane lub długo nieodświeżane. Jeśli Googlebot pobiera ważną stronę, lecz ta nie trafia do indeksu, sprawdź jakość treści, canonical, blokady i raport indeksowania.
Raport Statystyki indeksowania znajdziesz w Google Search Console w ścieżce Ustawienia > Statystyki indeksowania. Pokazuje historię żądań, odpowiedzi serwera, typy plików i problemy z dostępnością. Inspekcja adresu URL służy do sprawdzania pojedynczej strony, a logi serwera pozwalają analizować konkretne ścieżki i parametry.
Search Console nie zastępuje logów, gdy trzeba ustalić, które wzorce adresów Googlebot faktycznie odwiedza. Raport indeksowania pokazuje stan adresów na poziomie serwisu, natomiast logi zapisują rzeczywiste żądania HTTP. Porównuj te same okresy i uwzględniaj zweryfikowane żądania Googlebota.
Poniższa tabela pomaga rozpoznać, czy objaw dotyczy pobierania strony, czy jej dalszej oceny. Zacznij od danych w kolumnie wskazanej przy konkretnym symptomie.
| Objaw | Możliwa przyczyna | Dane do sprawdzenia | Pierwszy krok |
|---|---|---|---|
| Ważne URL-e rzadko pojawiają się w logach | Słabe linkowanie lub konkurencja innych adresów | Logi i linki wewnętrzne | Sprawdź linki HTML do stron |
| Googlebot często pobiera parametry | Nadmiar filtrów lub sortowania | Logi i wzorce URL | Oceń wartość wariantów dla wyszukiwarki |
| URL jest pobierany, ale niezaindeksowany | Jakość, duplikacja lub canonical | Inspekcja URL i canonical | Sprawdź treść i adres kanoniczny |
| Logi pokazują błędy 5xx lub 429 | Błąd serwera lub ograniczanie żądań | Logi odpowiedzi i statystyki indeksowania | Sprawdź dostępność hosta w czasie błędów |
Tabela rozdziela częstotliwość pobierania od oceny strony po pobraniu. Pojedynczy status nie przesądza o przyczynie, więc przed zmianą robots.txt porównaj dane z zamierzonym sposobem indeksowania.
Jak hreflang wpływa na crawlowanie i interpretację wersji?
Hreflang to adnotacja wskazująca powiązane wersje językowe lub regionalne strony; pomaga Google dobrać wariant do użytkownika, ale nie blokuje crawlowania ani nie gwarantuje indeksacji. Google opisuje zasady wdrażania w dokumentacji zlokalizowanych wersji stron.
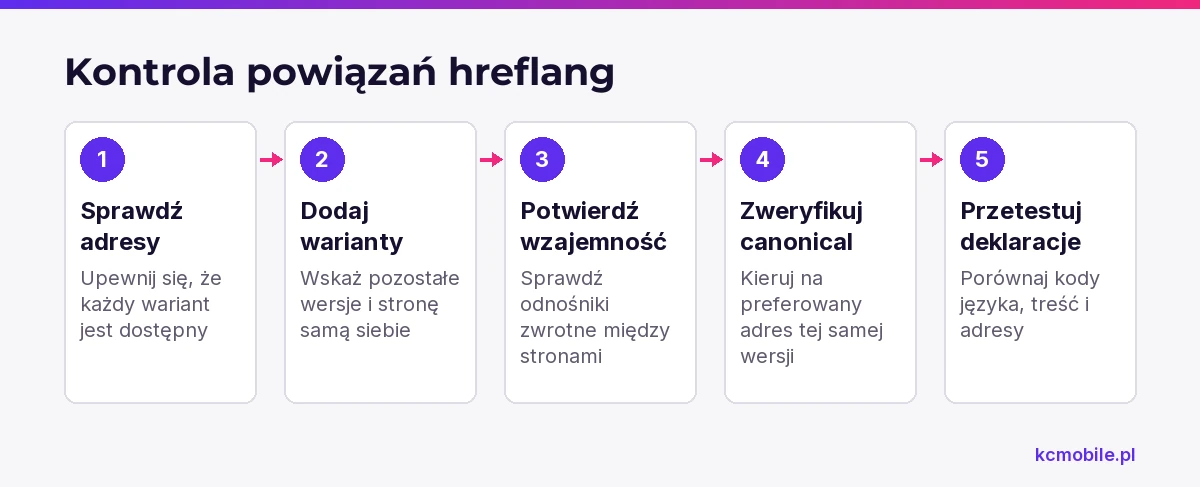
Każda strona w zestawie powinna wskazywać samą siebie oraz pozostałe wersje, a odnośniki muszą być wzajemne. Jeśli polska strona wskazuje angielską, angielska powinna wskazywać polską. Google może zignorować niepoprawne lub niepełne adnotacje.
Wartości hreflang powinny używać kodu języka, a opcjonalnie także regionu. Przykłady to `pl` dla polskiego, `en` dla angielskiego i `en-GB` dla angielskiego używanego w Wielkiej Brytanii. Każdy adres w `href` powinien prowadzić do pełnego, dostępnego URL-a właściwej strony, a nie do przekierowania, błędu lub wariantu o innej treści.
Canonical każdej wersji powinien wskazywać preferowany adres tej samej wersji, jeśli ma być osobno indeksowana. Kierowanie canonical wszystkich języków na stronę polską może zasygnalizować Google, że pozostałe warianty są duplikatami do scalenia. Sprawdź spójność canonical i wzajemnych adnotacji hreflang.
Google pozwala wdrożyć hreflang w kodzie HTML, nagłówku HTTP albo mapie witryny XML. Wybierz metodę, którą zespół może utrzymywać i testować; poprawność powiązań jest ważniejsza od liczby użytych metod.
Do częstych błędów należą brak odnośnika zwrotnego, nieosiągalny adres, wskazywanie strony przekierowującej oraz niezgodność deklarowanego języka z treścią. Kontrolę wykonaj crawlerem SEO, a następnie potwierdź w kodzie strony i raportach Google.
Jak uporządkować mapy witryn dla wielu języków?
Mapa witryny powinna wskazywać kanoniczne adresy przeznaczone do indeksowania. Możesz podzielić mapy według języka, typu treści lub wielkości, jeśli każdy wpis jest aktualny i prowadzi do docelowej strony.
Google dopuszcza oznaczanie wariantów językowych w mapie XML za pomocą elementów `xhtml:link`. Każdy URL w takim zestawie powinien zawierać wpisy dla wszystkich wariantów, w tym dla siebie. Hreflang można też umieścić w HTML albo nagłówku HTTP; wybierz sposób, który łatwo utrzymać w CMS.
Poniższa tabela pokazuje, jakie warunki sprawdzić w mapie dla wersji wielojęzycznych. Weryfikuj adresy, które mają być indeksowane, zamiast wszystkich URL-i generowanych przez CMS.
| Kontrola | Warunek poprawności | Sygnał problemu | Działanie |
|---|---|---|---|
| Status URL | Odpowiedź 200 | Błąd lub przekierowanie | Zaktualizuj adres w mapie |
| Canonical | Wskazuje preferowaną wersję strony | Wskazuje inny język bez uzasadnienia | Uzgodnij canonical ze strukturą |
| Hreflang | Warianty wskazują się wzajemnie | Brak odnośnika zwrotnego | Uzupełnij zestaw wszystkich wersji |
| Aktualność | Mapa odzwierciedla publikacje i usunięcia | Zawiera wycofane adresy | Generuj mapę z aktualnych danych CMS |
Mapa powinna opisywać strony przeznaczone do indeksowania, a nie wszystkie kombinacje adresów. Wycofane warianty usuń po wdrożeniu zaplanowanego przekierowania lub innej obsługi.
Jak ograniczyć marnowanie crawlowania?
Marnowanie crawlowania ograniczysz, porządkując adresy prowadzące do duplikatów, niepotrzebnych filtrów, łańcuchów przekierowań i błędnych stron. Najpierw ustal, które warianty są potrzebne użytkownikom oraz wyszukiwarce, a potem popraw ich generowanie i linkowanie.
Wykonaj następujące kroki:
1. W logach serwera wyszukaj najczęściej pobierane ścieżki, parametry i kody odpowiedzi Googlebota.
2. Porównaj te adresy z listą stron, które mają być dostępne do indeksowania.
3. Usuń zbędne linki wewnętrzne do parametrów i kieruj linkowanie na preferowane URL-e.
4. Skróć łańcuchy przekierowań i popraw błędy serwera oraz strony błędów zwracające kod 200.
5. Uporządkuj filtry i sortowanie, aby nie tworzyły nieograniczonej liczby adresów.
Robots.txt kontroluje dostęp robotów do adresów, ale sama blokada nie usuwa strony z indeksu. Gdy Google nie może pobrać strony, może nie odczytać umieszczonej na niej dyrektywy `noindex`. Do wykluczenia dostępnej strony z wyników użyj `noindex` albo ogranicz dostęp; nie polegaj wyłącznie na robots.txt.
Przy przeciążeniu serwera Google może ograniczyć crawlowanie. Kody 503 lub 429 stosuje się tymczasowo do sygnalizowania niedostępności albo ograniczenia żądań, a nie do rutynowego usuwania duplikatów. Dokumentacja Google zaleca uważne monitorowanie takich odpowiedzi, ponieważ utrzymywane przez kilka dni mogą spowodować spowolnienie crawlowania lub usunięcie URL-i z indeksu.
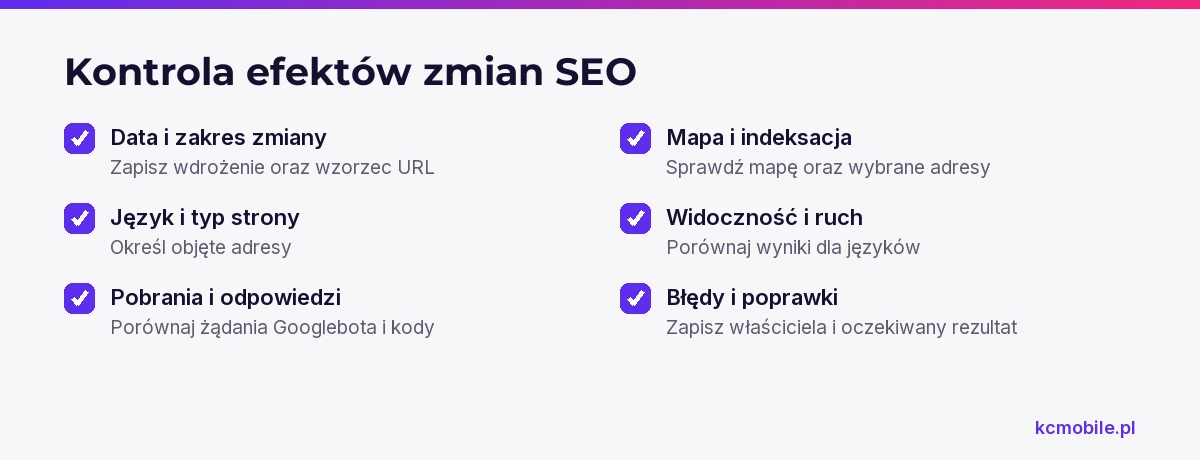
Po wdrożeniu zapisz datę, zakres URL-i i oczekiwany efekt. Dzięki temu porównasz logi oraz stan indeksowania dla adresów objętych zmianą.
Jak ustalić priorytety wersji językowych?
Priorytet wersji językowej ustal na podstawie popytu, kompletności lokalizacji, wartości biznesowej i stanu technicznego. Wersja z potencjalnymi klientami i pełną ofertą zwykle zasługuje na wcześniejsze prace niż wariant z pustymi podstronami i niespójnymi adresami.
Oceń każdą wersję według zapotrzebowania użytkowników, kompletności tłumaczeń, linkowania wewnętrznego i wyników biznesowych. Następnie upewnij się, że kluczowe strony są dostępne dla robota, zwracają prawidłowe odpowiedzi i mają właściwe adresy kanoniczne.
| Wariant językowy | Popyt użytkowników | Kompletność treści | Stan indeksacji | Zalecane działanie |
|---|---|---|---|---|
| Pełna oferta z ruchem | Wysoki | Wysoka | Stabilny | Rozwijaj treści i ofertę |
| Popyt przy lukach w tłumaczeniu | Wysoki | Niska | Nierówny | Uzupełnij ważne strony |
| Brak potwierdzonego popytu | Niski | Wysoka | Stabilny | Porównaj koszty utrzymania z wynikami |
| Puste strony i błędy techniczne | Nieustalony | Niska | Problematyczny | Wstrzymaj publikację kolejnych wariantów |
Tabela wspiera decyzję o kolejności prac, ale nie szereguje automatycznie rynków. Przed wycofaniem języka sprawdź jego ruch, konwersje, linki zewnętrzne i zobowiązania wobec użytkowników.
Wariant można etapowo uzupełnić, ograniczyć albo wycofać zależnie od danych i sposobu obsługi istniejących adresów. Nie publikuj całego katalogu w nowym języku, jeśli tłumaczenia, oferta i ścieżka zakupowa nie są gotowe. W WordPressie organizację wersji językowych warto zaplanować przed uruchomieniem kolejnych sekcji.
Jak monitorować efekty zmian technicznych?
Efekty zmian technicznych monitoruj, porównując pobrania Googlebota, statusy odpowiedzi, indeksację, widoczność i ruch osobno dla każdej wersji językowej. Przed wdrożeniem zapisz stan bazowy oraz datę zmiany, aby odróżnić jej wpływ od sezonowości i innych prac w serwisie.
W logach serwera filtruj zweryfikowane żądania Googlebota i grupuj je według ścieżki językowej, kodu odpowiedzi oraz wzorca parametrów. W Google Search Console sprawdzaj raport Statystyki indeksowania, a Inspekcją adresu URL weryfikuj wybrane strony. Wzrost liczby żądań nie oznacza automatycznie wzrostu widoczności.
Rejestr zmian powinien zawierać następujące informacje:
- Data wdrożenia i opis zmienionego wzorca URL.
- Język, typ strony i liczba adresów objętych zmianą.
- Kody odpowiedzi oraz liczba pobrań Googlebota z logów.
- Liczba adresów w mapie i stan wybranych URL-i w Inspekcji adresu URL.
- Widoczność i ruch organiczny z podziałem na języki.
- Wykonane poprawki, ich właściciel i oczekiwany rezultat.
Po wdrożeniu sprawdź, czy nie wzrosła liczba błędów serwera, blokad lub nieprawidłowych canonical. Potem oceń, czy Googlebot odwiedza ważne strony i czy zmieniły się statusy indeksowania. Widoczność i ruch porównuj na podobnych okresach, uwzględniając sezonowość i równoległe zmiany treści.
Perspektywa KC Mobile: w serwisie wielojęzycznym najwięcej pracy diagnostycznej wymaga często uzgodnienie tego, co CMS publikuje, co mapa witryny deklaruje, a co robot faktycznie pobiera. Przed wyłączeniem języka lub blokowaniem ścieżki sprawdzamy te źródła i dopiero potem wybieramy zmianę techniczną.
Jeśli rozwijasz stronę na WordPressie, przygotowanie serwisu WordPress może objąć zaplanowanie struktury adresów, wersji językowych i sposobu publikowania treści. Po wdrożeniu opieka nad WordPressem obejmuje bieżące prace techniczne i rozwojowe przy stronie.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Czy każda wersja językowa zwiększa crawl budget?
Jak sprawdzić, czy Google crawluje strony w różnych językach?
Czy hreflang zużywa crawl budget?
Czy warto blokować niepotrzebne wersje językowe w robots.txt?
Jak ograniczyć duplikaty URL w wielojęzycznym serwisie?
Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „Wersje językowe i ich wpływ na crawl budget w SEO”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.