Awaria strony może oznaczać utratę sprzedaży, ale problem bywa ograniczony do formularza, płatności albo połączenia z jednej sieci. Monitoring pomaga wykryć symptom, a sprawna reakcja wymaga listy kontrolowanych adresów i osoby odpowiedzialnej za alarm.
Krótka odpowiedź
WebPing sprawdza dostępność wskazanego adresu i może wyszukiwać w jego kodzie HTML konkretny ciąg znaków. Według oficjalnej strony sprawdzonej w październiku 2026 plan one kontroluje adres co 10 minut, a plany start, standard, professional i enterprise co 1 minutę; dostępne kanały powiadomień obejmują e-mail, SMS i Facebook Messenger.
Kontrola adresu nie potwierdza poprawności całego procesu zamówienia, płatności ani dowolnej integracji API.
Usługi KC Mobile
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „WebPing i monitoring dostępności strony: jak skonfigurować alerty i reagować na awarie”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.
Czym jest WebPing i co sprawdza monitoring dostępności?
WebPing to usługa monitorowania dostępności strony, która sprawdza wskazany adres i może szukać w jego kodzie HTML konkretnego ciągu znaków. W FAQ WebPing podaje jako przykłady tytuł strony oraz identyfikator Google Analytics lub Google Tag Manager; stan informacji sprawdzono w październiku 2026.
Monitoring dostępności odpowiada na pytanie, czy wskazany adres działa i zawiera oczekiwany element. Monitoring wydajności mierzy między innymi czas odpowiedzi, a test transakcji sprawdza, czy użytkownik może przejść przez proces zakupu. To odrębne rodzaje kontroli i nie należy traktować ich jako zamienników.
Odpowiedź HTTP 200 nie dowodzi, że sklep przyjmuje zamówienia. Strona może się otwierać, gdy koszyk jest pusty, operator płatności nie działa albo formularz odrzuca dane. W WebPing adres checkoutu i wybrana fraza mogą sygnalizować problem na tej stronie, ale nie zastąpią testu kompletnego zamówienia.
Alert wskazuje objaw, nie zawsze jego przyczynę. Brak odpowiedzi może wynikać z hostingu, DNS, certyfikatu SSL, przeciążenia serwera albo problemu sieciowego między lokalizacją kontrolną a serwerem.
Czytasz poradnik „WebPing i monitoring dostępności strony: jak skonfigurować alerty i reagować na awarie”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny. Omów temat tego poradnika
Jak ustawić monitoring strony w WebPing?
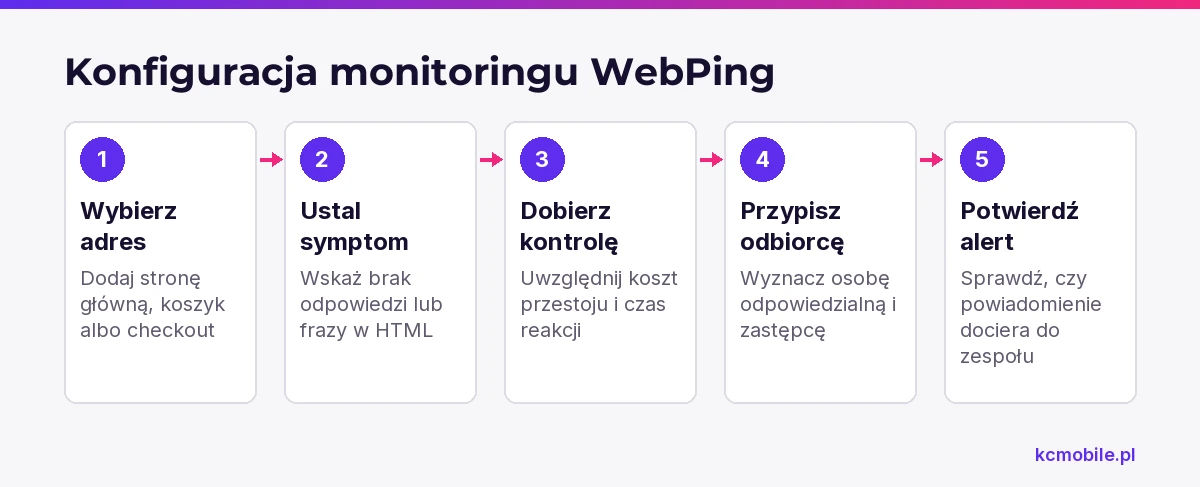
Monitoring w WebPing uruchomisz, dodając usługę w panelu klienta, podając jej adres i opcjonalnie frazę do sprawdzania w HTML. FAQ usługi opisuje konfigurację monitorowania w panelu klienta, a oficjalna strona wymienia alerty e-mail, SMS i Facebook Messenger; informacje sprawdzono w październiku 2026.
Dla każdego adresu określ, jaki symptom ma wykrywać. Strona główna sygnalizuje dostępność serwisu, a adres koszyka może ujawnić problem na tym etapie. Fraza kontrolna powinna być stałym elementem HTML, który jest obecny przy prawidłowym działaniu strony. WebPing wymienia między innymi tytuł strony i identyfikator narzędzia analitycznego.
Częstotliwość kontroli dobierz do możliwego kosztu przestoju i czasu, w którym zespół może zareagować. Oficjalny cennik WebPing podaje w październiku 2026 kontrolę co 10 minut w planie one oraz co 1 minutę w planach start, standard, professional i enterprise. Plany od start obejmują też kontrolę ważności domeny i certyfikatu SSL. Nie podajemy cen usługi, ponieważ zależą od aktualnego cennika producenta.
Przypisz alert osobie, która może podjąć działanie, i wyznacz zastępcę. Po zapisaniu ustawień potwierdź, że wiadomość dociera do właściwego odbiorcy, korzystając z dostępnej próby albo bezpiecznego scenariusza testowego, który nie wywoła nieplanowanej awarii produkcyjnej.
Jeśli równolegle planujesz prace nad widocznością i stanem technicznym serwisu, pozycjonowanie SEO może obejmować analizę techniczną ważnych adresów. Dostępność warto oceniać razem z tym, czy strona działa poprawnie dla użytkowników i może pozyskiwać ruch z wyszukiwarki.
Co monitorować na stronie firmowej i w sklepie?
Sklep powinien kontrolować stronę główną, koszyk, checkout, domenę i certyfikat SSL, a integracje sprawdzać osobnym testem dopasowanym do ich działania. Checkout to etap, w którym klient podaje dane i finalizuje zamówienie; kontrola strony głównej nie wykryje błędu płatności.
WebPing sprawdza wskazany adres i może wyszukiwać na nim ciąg znaków w HTML. Nawet podanie adresu API lub strony operatora nie zmienia tego w pełny test API ani transakcji. Dla integracji zaplanuj odrębne sprawdzenie po stronie sklepu lub systemu integracyjnego.
Poniższa tabela pokazuje, jaki symptom może ujawnić kontrola adresu i kto powinien zareagować. Dla płatności oraz innych integracji trzeba osobno potwierdzić poprawność działania procesu.
| Element kontroli | Przykładowy adres lub usługa | Co może sygnalizować WebPing | Odpowiedzialny za reakcję |
|---|---|---|---|
| Strona główna | / | Brak odpowiedzi lub brak frazy w HTML | Administrator strony |
| Koszyk | /koszyk/ | Brak odpowiedzi lub brak frazy w HTML | Administrator sklepu |
| Checkout | /zamowienie/ | Dostępność adresu, nie poprawność zamówienia | Administrator sklepu |
| Domena | Domena sklepu | Zbliżający się termin wygaśnięcia w planach od start | Właściciel domeny |
| Certyfikat SSL | Adres HTTPS sklepu | Zbliżający się termin wygaśnięcia w planach od start | Administrator hostingu |
| Integracja płatności | Adres usługi lub API | Odpowiedź adresu, nie pełna transakcja | Właściciel integracji |
Tabela oddziela sygnały możliwe do uzyskania z adresu od testów wymagających odrębnego scenariusza. Status strony nie potwierdza przesłania danych ani zaksięgowania płatności.
Jak dobrać częstotliwość kontroli i powiadomienia?
Częstotliwość kontroli dobierz do kosztu przestoju, godzin sprzedaży i czasu potrzebnego na reakcję. WebPing podaje w październiku 2026 kontrolę co 10 minut w planie one oraz co 1 minutę w planach start, standard, professional i enterprise.
Zacznij od określenia, kiedy sklep przyjmuje zamówienia i kto może odebrać alarm. Sklep działający przez całą dobę może wymagać dyżuru poza standardowymi godzinami pracy, a formularz wykorzystywany podczas kampanii reklamowej może potrzebować osobnej ścieżki eskalacji. Ustal, kto potwierdza alarm i kiedy przekazuje go administratorowi lub hostingowi.
Nadmierna liczba alarmów dotyczących mało istotnych adresów zwiększa ryzyko, że odbiorcy zaczną je ignorować. Grupuj kontakty według rodzaju problemu i przypisz osobną ścieżkę dla domeny, checkoutu oraz całkowitej niedostępności. WebPing wymienia e-mail, SMS i Facebook Messenger, więc wybierz kanał, który odbiorca monitoruje podczas dyżuru.
Z naszych wdrożeń wynika, że alarm działa operacyjnie dopiero wtedy, gdy odbiorca zna swoją rolę i może przekazać problem dalej. Zalecamy opisać progi eskalacji obok listy monitorowanych adresów, a nie tylko w konfiguracji konta.
Co zrobić po alercie o niedostępności?
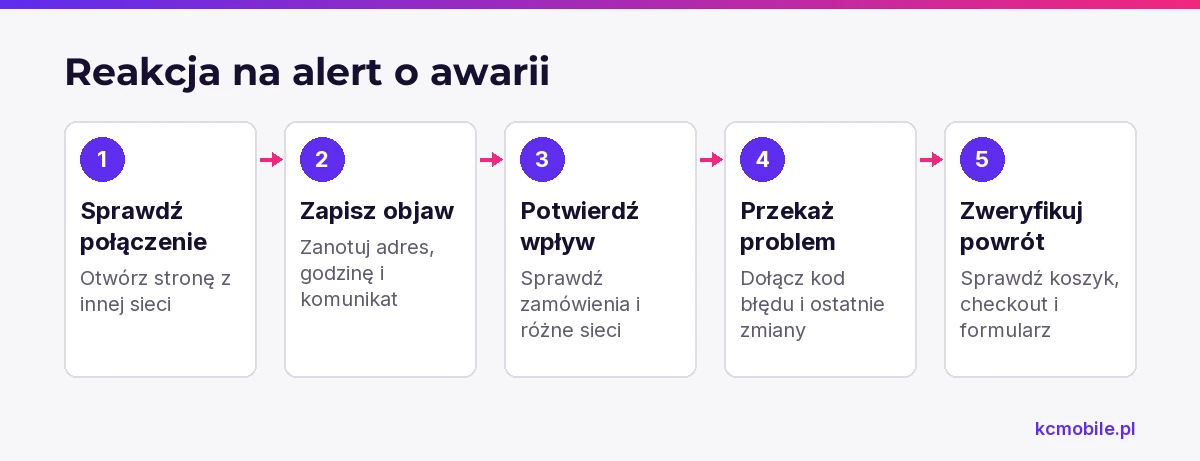
Po alercie sprawdź stronę z innej sieci i zapisz godzinę, adres oraz treść komunikatu. Taka kontrola pomaga odróżnić awarię serwisu od problemu z lokalnym połączeniem.
Właściciel sklepu sprawdza, czy napływają zamówienia i czy błąd występuje w różnych sieciach. Administrator strony weryfikuje odpowiedź serwera, logi, ostatnie wdrożenia oraz połączenia z usługami zewnętrznymi. Zgłoszenie do hostingu powinno zawierać adres, czas zdarzenia, kod błędu i informację, czy problem jest stały.
Po przywróceniu działania sprawdź koszyk, checkout i formularz. Przy płatnościach użyj bezpiecznego scenariusza testowego, który nie tworzy przypadkowego zamówienia ani obciążenia klienta. Zapisz czas wykrycia, przywrócenia działania i potwierdzoną przyczynę; nie zamykaj incydentu na podstawie samej strony głównej.
Jeśli awaria wystąpiła bezpośrednio po aktualizacji wtyczki, motywu lub integracji, wstrzymaj kolejne zmiany do czasu diagnozy. Przy błędach DNS, certyfikatu lub przeciążeniu serwera przekaż administratorowi albo hostingowi dokładny adres i komunikat z alertu.
Jak powiązać alert z szybką diagnozą i eskalacją?
Każdy alert powinien wskazywać pierwszą kontrolę, osobę odpowiedzialną i warunek przekazania problemu dalej. Procedurę przechowuj w miejscu dostępnym dla osób, które odbierają powiadomienia.
Poniższa tabela odpowiada na pytanie, co zrobić po konkretnym alercie i kiedy eskalować sprawę. Dostosuj role do uprawnień zespołu i kontaktów używanych przy utrzymaniu sklepu.
| Alert | Pierwsza kontrola | Odpowiedzialny | Warunek eskalacji |
|---|---|---|---|
| Strona nie odpowiada | Porównaj wynik z innej sieci | Właściciel sklepu | Problem występuje w kilku sieciach |
| Błąd HTTP 5xx | Zapisz godzinę i kod odpowiedzi | Administrator strony | Błąd powtarza się lub obejmuje kilka adresów |
| Checkout nie działa | Wykonaj bezpieczny test zamówienia | Administrator sklepu | Zamówienie nie dochodzi do potwierdzenia |
| Ostrzeżenie SSL | Sprawdź datę i nazwę certyfikatu | Administrator hostingu | Certyfikat wygasł lub nazwa hosta jest niezgodna |
| Alarm domeny | Sprawdź konto rejestratora i termin odnowienia | Właściciel domeny | Nie można potwierdzić odnowienia |
Problem serwera lub sieci przekaż hostingowi, a błąd po zmianie kodu, wtyczki albo konfiguracji sklepu wykonawcy strony. Godzina, adres i treść alertu ułatwiają diagnozę.
Jak oszacować koszt przestoju sklepu?
Szacunkowy koszt utraconej marży obliczysz, mnożąc średnią liczbę zamówień na godzinę przez średnią marżę na zamówieniu i czas awarii w godzinach. Dla firmy pozyskującej kontakty użyj liczby leadów na godzinę i własnej wartości leada.
Wzór dla sklepu: koszt utraconej marży = średnia liczba zamówień na godzinę x średnia marża na zamówieniu x liczba godzin awarii. Wzór dla firmy pozyskującej kontakty: koszt utraconych leadów = średnia liczba leadów na godzinę x wartość leada x liczba godzin awarii.
Użyj danych z porównywalnego dnia lub przedziału, ponieważ ruch i konwersja zmieniają się w czasie. Wynik jest szacunkiem utraconej marży albo wartości leadów, a nie pełnym kosztem awarii. Nie uwzględnia odroczonych zakupów, kosztów reklamacji ani wpływu na zaufanie klientów.
Zapisuj osobno czas wykrycia, potwierdzenia i przywrócenia działania. Te znaczniki pokazują, czy najwięcej czasu zajmuje rozpoznanie problemu, eskalacja czy naprawa.
Jak sprawdzić, czy monitoring rzeczywiście działa?
Monitoring działa operacyjnie, gdy obejmuje krytyczne adresy, wykrywa określony symptom, wysyła alert do właściwej osoby i pozwala potwierdzić powrót usługi. Sama aktywna konfiguracja nie wystarcza, jeśli odbiorca nie wie, jak zareagować.
Przeglądaj historię zdarzeń, listę adresów i kanały powiadomień. Po zmianie odbiorcy lub dyżuru potwierdź, że alert trafia do właściwej osoby. Aktualizuj listę adresów po zmianie domeny, koszyka, checkoutu lub integracji.
Testuj reakcję zespołu, a nie tylko wysyłkę wiadomości. Odbiorca alertu powinien wiedzieć, gdzie potwierdzić incydent, kogo powiadomić i jakie dane przekazać hostingowi. Jeśli alert trafia do spamu albo nikt nie zna procedury, monitoring wymaga poprawy.
W sklepie WooCommerce sprawdź zamówienie po aktualizacji wtyczek, motywu lub integracji płatniczej. Przy ocenie szerszego stanu technicznego serwisu przydatne może być narzędzie do analizy technical SEO. Jeśli potrzebujesz uporządkować widoczność i techniczne podstawy serwisu, prowadzenie pozycjonowania SEO może objąć analizę techniczną ważnych podstron.
Więcej poradników w tym temacie
Wspomniane narzędzia
Najczęściej zadawane pytania
Czy WebPing wykryje, że klient nie może zapłacić za zamówienie?
Czy alert WebPing oznacza, że strona nie działa dla wszystkich?
Kto powinien otrzymywać powiadomienie o awarii sklepu?
Czy WebPing monitoruje termin ważności domeny i certyfikatu SSL?
Jak często testować działanie powiadomień?

Krzysztof Czapnik
Founder & Technical Lead, KC Mobile
Projektuję i rozwijam strony WordPress, sklepy WooCommerce oraz aplikacje internetowe. Łączę projektowanie z programowaniem, integracjami i technicznym SEO. Projekty KC Mobile prowadzę osobiście.
Potrzebujesz pomocy z tym tematem? Napisz - odpowiem osobiście w 24h.
Potrzebujesz pomocy w tym temacie?
Czytasz poradnik „WebPing i monitoring dostępności strony: jak skonfigurować alerty i reagować na awarie”. Napisz, co chcesz zrobić i na jakim etapie jesteś. Ustalimy, czy możemy pomóc i jaki zakres prac będzie potrzebny.